Kimi K3.1 Pro 가격과 성능, 코딩 에이전트에는 어떻게 쓰나?
Kimi K3.1 Pro는 Moonshot AI가 K3를 사후 학습한 모델로, 100만 토큰 컨텍스트 창에 입력 $2, 출력 $10 API 가격이며 2026년 11월 4일까지 웨이트를 공개한다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- Kimi K3.1 Pro는 Moonshot AI K3.1 시리즈의 첫 모델로, Kimi K3를 사후 학습했고 컨텍스트 창은 100만 토큰이다.
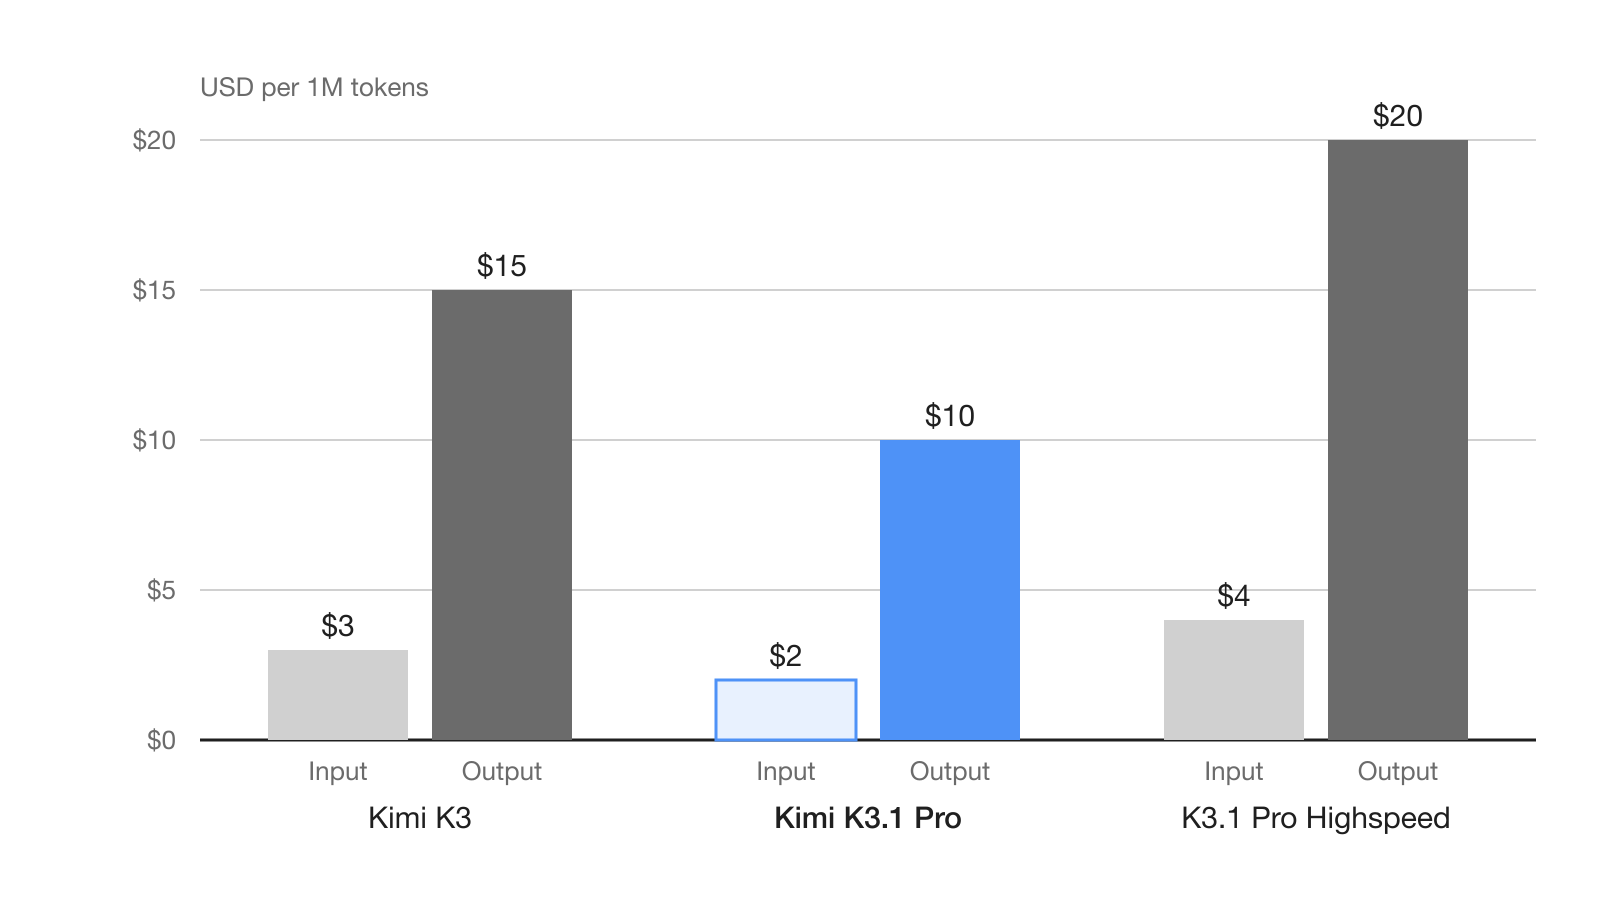
- API 가격은 100만 토큰당 입력 $2.00, 출력 $10.00으로 Kimi K3보다 3분의 1 낮다.
- Moonshot은 Claude-Code 하니스에서 잰 Terminal-Bench 4.0 점수를 65.7%로 발표했다.
- 전체 웨이트는 2026년 11월 4일까지 공개하며, 사이버 관련 학습 데이터는 뺐다.
이 글의 차례
Kimi K3.1 Pro는 Moonshot AI가 새로 내놓은 K3.1 시리즈의 첫 모델이다. Kimi K3를 사후 학습한 버전으로 컨텍스트 창은 100만(1M) 토큰이며, 출시 글은 당일부터 배포를 시작한다고 밝혔다 [1]. API 가격은 100만 토큰당 입력 $2.00, 출력 $10.00으로 K3보다 3분의 1 싸다 [3]. 더 빠른 Highspeed 변형이 함께 나왔고, Moonshot은 2026년 11월 4일까지 전체 웨이트를 공개할 계획이다 [1].
Kimi K3.1 Pro는 어떤 모델인가?
Kimi K3.1 Pro는 Moonshot AI K3.1 시리즈의 첫 모델로, Kimi K3에 훨씬 많은 사후 학습 연산을 들여 만들었다 [1]. Moonshot은 이 모델이 지금까지 내놓은 3T급 오픈 웨이트 모델 가운데 가장 뛰어나다고 소개한다. 배포 대상은 Kimi.ai, Kimi 모바일 앱, Kimi Work, Kimi Code, Kimi API다. Moonshot이 2~3배 빠르다고 밝힌 Kimi K3.1 Pro Highspeed도 함께 나온다.
출시 글은 구조를 다시 설명하지 않으므로 베이스 모델을 기준으로 봐야 한다. Kimi K3는 전문가 혼합(mixture-of-experts) 모델로, 전체 파라미터는 2.8T, 활성 파라미터는 104B다. 전문가 896개 가운데 토큰마다 16개를 고르고 공유 전문가 2개를 더 쓰며, 컨텍스트 길이는 1,048,576 토큰이다 [4]. 웨이트는 Kimi K3 License로, MXFP4 형식으로 공개돼 있다. K3.1 Pro 웨이트에 어떤 라이선스를 붙일지는 Moonshot이 아직 밝히지 않았다.
| 항목 | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| API 모델 ID | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
| 컨텍스트 창 | 1,048,576 토큰 | 1,048,576 토큰 |
| 입력(100만 토큰당) | $2.00 | $4.00 |
| 출력(100만 토큰당) | $10.00 | $20.00 |
| 캐시된 입력(100만 토큰당) | $0.20 | $0.20 |
| 캐시 쓰기(5분) | $2.00 | $4.00 |
| 캐시 쓰기(1시간) | $4.00 | $8.00 |
가격은 2026년 10월 24일에 확인한 Moonshot 가격 페이지 기준이다 [3]. 모델 ID는 API 퀵스타트에서 가져왔다 [2].
Kimi K3와 비교해 무엇이 달라졌나?
크게 달라진 점은 가격, 사후 학습, 그리고 긴 에이전트 작업에 집중하겠다는 방향이다. Kimi K3의 정가는 100만 토큰당 입력 $3.00, 출력 $15.00, 캐시된 입력 $0.30이다. 그래서 K3.1 Pro 표준 요금은 세 항목 모두 3분의 1 낮다 [3]. Highspeed는 일반 입력, 출력, 캐시 쓰기 요금이 두 배지만 캐시된 입력 요금은 $0.20으로 같다.
Moonshot이 자체적으로 만든 장기 코딩 테스트 Kimi Code Bench 3.0에서 K3.1 Pro는 61.2%를 기록해 K3의 55.95%를 앞섰다 [1]. 사실 정확도를 일부러 세게 시험하는 내부 테스트 Kimi Hallu Bench Hard에서는 주장 단위 환각률이 K3의 23.4%에서 8.3%로 내려갔다. 다만 Moonshot은 이 환각 수치가 일부러 어렵게 만든 프롬프트에서 나온 값이고, 평소 사용할 때의 오류율을 뜻하지 않는다고 밝힌다.
이번 출시는 코드 밖의 실무 작업에도 힘을 실었다. Moonshot은 실제 재무 문서로 재정 데이터 분석 능력을 시험하는 OfficeQA Pro v2에서 64.4를 기록했다고 밝혔다. Blender와 CAD에서 하는 파라메트릭 3D 모델링, Unity, Unreal Engine, Godot으로 만드는 게임 프로젝트 작업도 사례로 든다 [1].
코딩 에이전트로 쓸 때 Kimi K3.1 Pro 점수는 어떤가?
Moonshot은 Terminal-Bench 4.0에서 K3.1 Pro가 65.7%를 기록했다고 발표했다. GPT-6 Astra의 58.2%보다 높고 Claude Opus 5.5의 66.4%보다 조금 낮다 [1]. 각주를 보면 K3.1 Pro는 Claude-Code 하니스(harness)로 평가했고, 다른 모델 점수는 각 회사 발표 글이나 공식 리더보드에 나온 값 가운데 가장 높은 값을 썼다.
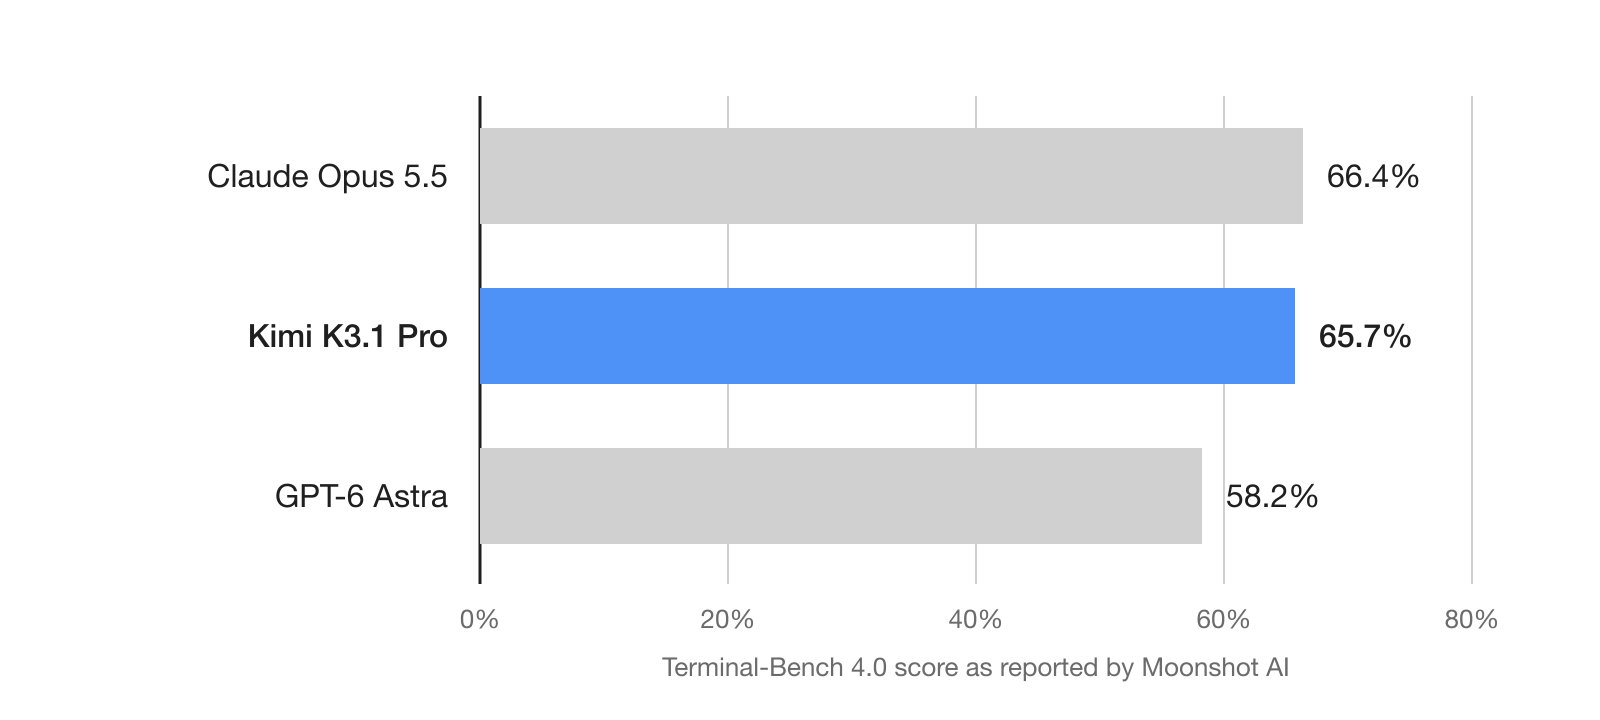
점수를 비교할 때는 이 하니스 조건을 꼭 따져 봐야 한다. 여러 코딩 결과의 각주에도 Claude-Code 하니스가 적혀 있는데, 여기에는 Terminal-Bench-Science, DeepSWE, SWE-Marathon, PostTrainBench, ProgramBench가 들어간다 [1]. 따라서 이 점수들은 모델 단독 성능이 아니라 특정 에이전트 루프 안에서 낸 성능이다. 직접 쓰는 하니스와 툴, 프롬프트에서는 결과가 다르게 나올 수 있다.
API로 Kimi K3.1 Pro를 어떻게 호출하나?
Kimi K3.1 Pro는 OpenAI 호환 Chat Completions 엔드포인트로 호출한다. OpenAI Python SDK에 Moonshot의 기본 주소(base URL)만 지정하면 된다 [2]. 이 모델은 최소 $1을 충전해야 쓸 수 있고, 누적 충전액에 따라 계정 등급과 속도 제한(rate limit)이 정해진다. 퀵스타트 예제는 MOONSHOT_API_KEY 환경 변수에서 키를 읽는다.
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)

completion = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Introduce Kimi K3.1 Pro in one sentence."}],
)

print(completion.choices[0].message.content)
다른 OpenAI 호환 모델과 다른 규칙이 몇 가지 있고, 에이전트 루프를 짤 때는 이 차이가 중요하다 [2].
- 생각 모드는 항상 켜져 있다.
reasoning_effort에는low,high,max를 넣을 수 있고 기본값은max다. 추론 시간을 줄이려면low를 쓴다. - 어시스턴트 메시지를 통째로 돌려보낸다. 대화가 여러 번 오가거나 툴을 호출하는 흐름에서는
content만 떼어 내지 말고 어시스턴트 메시지 전체를 고치지 않은 채 다시 보낸다. 스트리밍 응답에서는 추론 내용이reasoning_content에 담긴다. - 샘플링 파라미터는 넣지 않는다.
temperature,top_p,n,presence_penalty,frequency_penalty는 값이 고정돼 있으므로 요청에서 아예 빼야 한다. - 출력 한도를 직접 정한다.
max_completion_tokens의 기본값은 131,072이고 최대 1,048,576까지 올릴 수 있다. - 미디어는 업로드해서 넣는다. 이미지는 공개 URL이 아니라 base64나
ms://파일 참조로 넣고, 동영상은purpose="video"로 업로드한다.
툴 호출은 사용자 정의 툴, tool_choice="required", 동적 툴 로딩을 지원한다. 동적 툴 로딩에서는 시스템 메시지에 넣은 툴 정의를 서버가 보관하지 않는다 [2]. 엄격한 json_schema를 쓰는 구조화된 출력과, 주어진 텍스트 앞부분에 이어서 쓰는 부분 모드(partial mode)도 쓸 수 있다.
캐싱은 자동으로 된다. 기본 캐시 유지 시간은 5분이고 prompt_cache_options.ttl로 1시간을 요청할 수 있다. 캐시 블록 하나를 다 채우지 못한 부분 블록은 캐시 미스로 과금된다 [2]. 가격은 컨텍스트 창 전체에서 같고, 긴 컨텍스트용 별도 요금 구간은 없다.
AI 에이전트를 쓰는 팀에는 어떤 의미인가?
팀 입장에서 Kimi K3.1 Pro는 긴 에이전트 작업을 더 싸게 맡길 수 있는 선택지이고, 웨이트가 나오면 자체 하드웨어에서도 돌릴 수 있다. 제품에서는 Kimi Code 사용자가 /model 명령으로 모델을 바꾼다. Kimi Work를 쓰려면 Windows나 Apple 실리콘 Mac에서 데스크톱 버전 3.1.0 이상이 필요하다 [1]. Kimi Enterprise에서는 출시 시점에 기본으로 꺼져 있어 관리자가 직접 켜야 하고, API 고객은 데이터를 남기지 않는 Zero Data Retention을 쓸 수 있다.
Highspeed는 Pro, Max, Ultra 멤버십 요금제에 들어 있고, API는 멤버십과 따로 쓴 만큼 과금된다 [3]. 생각 모드를 끌 수 없고 기본 강도가 max이므로, 다른 모델과 토큰당 가격을 비교하기 전에 자기 작업에서 low와 high 강도의 토큰 사용량부터 재 보는 편이 좋다 [2].
한계와 남은 질문은?
가장 큰 미지수는 웨이트다. Moonshot은 2026년 11월 4일까지 전체 웨이트를 공개한다고 밝혔지만 [1], 출시 글에는 라이선스가 나오지 않는다. 웨이트가 나오기 전까지 K3.1 Pro는 API와 앱에서만 쓸 수 있는 모델이다.
Moonshot은 오픈 공개를 앞두고 모델의 공격용 사이버 능력을 일부러 낮췄다. 중간 학습(mid-training)에서 사이버 관련 데이터를 빼고, 사이버 관련 강화학습(RL) 환경도 걸러 냈다. 내부 테스트 xdev-bench-hard에서 이런 조치를 하지 않은 체크포인트는 pass@3 기준으로 문제의 90.5%를 풀었고, 최종 모델은 81.0%를 풀었다 [1]. Moonshot은 K3.1 Pro의 사이버 능력이 공개된 지 최소 3개월 넘은 최상위 비공개 모델보다 여전히 뒤처진다고 설명한다.
퀵스타트는 웹 검색 기능을 손보고 있어 당분간 프로덕션에서는 쓰지 않기를 권한다고도 적었다 [2]. 끝으로 출시 글의 수치는 거의 모두 Moonshot이 직접 돌린 결과이고, 벤치마크 가운데 몇 개는 내부용이다. 이 수치는 결론이 아니라 직접 시험해 볼 이유로 받아들이는 편이 맞다.
자주 묻는 질문
Kimi K3.1 Pro 웨이트는 언제 공개되나?
Moonshot AI는 2026년 11월 4일까지 전체 모델 웨이트를 공개한다고 밝혔다. 출시 글에는 라이선스가 나오지 않으며, 앞서 나온 Kimi K3 웨이트는 Kimi K3 License를 따른다.
Kimi K3.1 Pro API 요금은 얼마인가?
100만 토큰당 입력 $2.00, 출력 $10.00, 캐시된 입력 $0.20이다. Highspeed 변형은 입력 $4.00, 출력 $20.00이고, 100만 토큰 컨텍스트 창 전 구간에서 가격이 같다.
Kimi K3.1 Pro에서 생각(thinking) 모드를 끌 수 있나?
끌 수 없다. Kimi K3.1 Pro는 생각 모드가 항상 켜져 있다. 대신 reasoning_effort를 기본값 max가 아닌 low로 두면 추론 시간을 줄일 수 있다.
Kimi K3.1 Pro API는 OpenAI SDK와 호환되나?
호환된다. 공식 퀵스타트 예제는 OpenAI Python SDK의 Chat Completions 방식에 Moonshot 주소만 바꿔 넣는다. 다만 temperature, top_p 같은 샘플링 파라미터는 값이 고정돼 있어 요청에 넣지 말아야 한다.
Terminal-Bench 4.0에서 Kimi K3.1 Pro와 Claude Opus 5.5를 비교하면 어떤가?
Moonshot 발표로는 Terminal-Bench 4.0에서 Kimi K3.1 Pro가 65.7%, Claude Opus 5.5가 66.4%이며, Kimi는 Claude-Code 하니스에서 돌렸다. 이 비교는 독립 평가가 아니라 Moonshot 출시 글에 실린 수치다.