Claude 메시지 스레드, 장기 실행 에이전트를 어떻게 빠르게 하나?
2026년 11월 2일 베타로 나온 Claude 메시지 스레드는 대화를 서버에 보관해, 에이전트가 턴마다 새 메시지만 보내면 되게 한다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- Claude 메시지 스레드는 2026년 11월 2일 Messages API에서 공개 베타로 나왔다.
- 첫 요청 뒤로는 에이전트가 새 메시지와 직전 응답 ID만 보낸다.
- 스레드는 마지막 요청 5분 뒤 만료되고, 404가 오면 전체 대화를 다시 보낸다.
- 가격, 속도 제한, 토큰 사용량은 그대로이고, 스레드는 ZDR 대상에서 빠진다.
이 글의 차례
메시지 스레드(message threads)는 2026년 11월 2일 발표된 Claude Messages API의 공개 베타 기능으로, 턴과 턴 사이에 대화를 Anthropic 서버에 보관한다. 에이전트는 전체 대화를 한 번만 보내고, 그 뒤로는 새 메시지와 직전 응답의 ID만 보낸다. Anthropic은 이 방식으로 긴 세션에서 첫 토큰까지 걸리는 시간이 줄고, 토큰 사용량과 가격, 속도 제한은 그대로라고 설명한다 [1][2].
Claude 메시지 스레드란 무엇인가?
메시지 스레드는 Messages API 대화를 서버에 잠시 복사해 두고, 이후 요청이 그 뒤에 메시지를 덧붙이게 하는 기능이다. thread 요청 파라미터와 베타 헤더 message-threads-2026-08-12를 붙이면 켜지고, 응답은 평소와 같은 메시지다 [2][3].
이 기능이 겨냥하는 문제는 에이전트 루프의 구조다. 스레드가 없으면 턴마다 대화 전체를 다시 올리고, API는 그 전체를 다시 검증하고 토큰화한다 [2]. 발표문은 코딩 에이전트가 세션 하나에서 요청을 수백 번 보낼 수 있다고 짚는다. 그러면 수십만 토큰짜리 기록이 여러 번 되풀이해 전송된다 [1].
Anthropic은 이미 자사 제품에서 이 기능을 쓰고 있다. 대부분의 Claude Code 사용자에게 메시지 스레드가 기본으로 켜져 있고, 500k~1M 토큰 규모의 요청에서 첫 토큰까지 걸리는 시간의 중앙값이 약 35% 줄었다 [1].
메시지 스레드는 어떻게 동작하나?
스레드의 동작은 생성(create), 이어 가기(continue), 재전송(replay) 세 가지다. 첫 요청에는 전체 대화와 system, tools, 그리고 "thread": {"type": "create"}를 담는다. API는 Claude의 답까지 포함한 대화를 응답 id 아래에 저장한다 [2]. 이후 요청은 새 메시지만 "thread": {"type": "continue", "previous_message_id": "<id>"}와 함께 보내고, system과 tools는 뺀다.
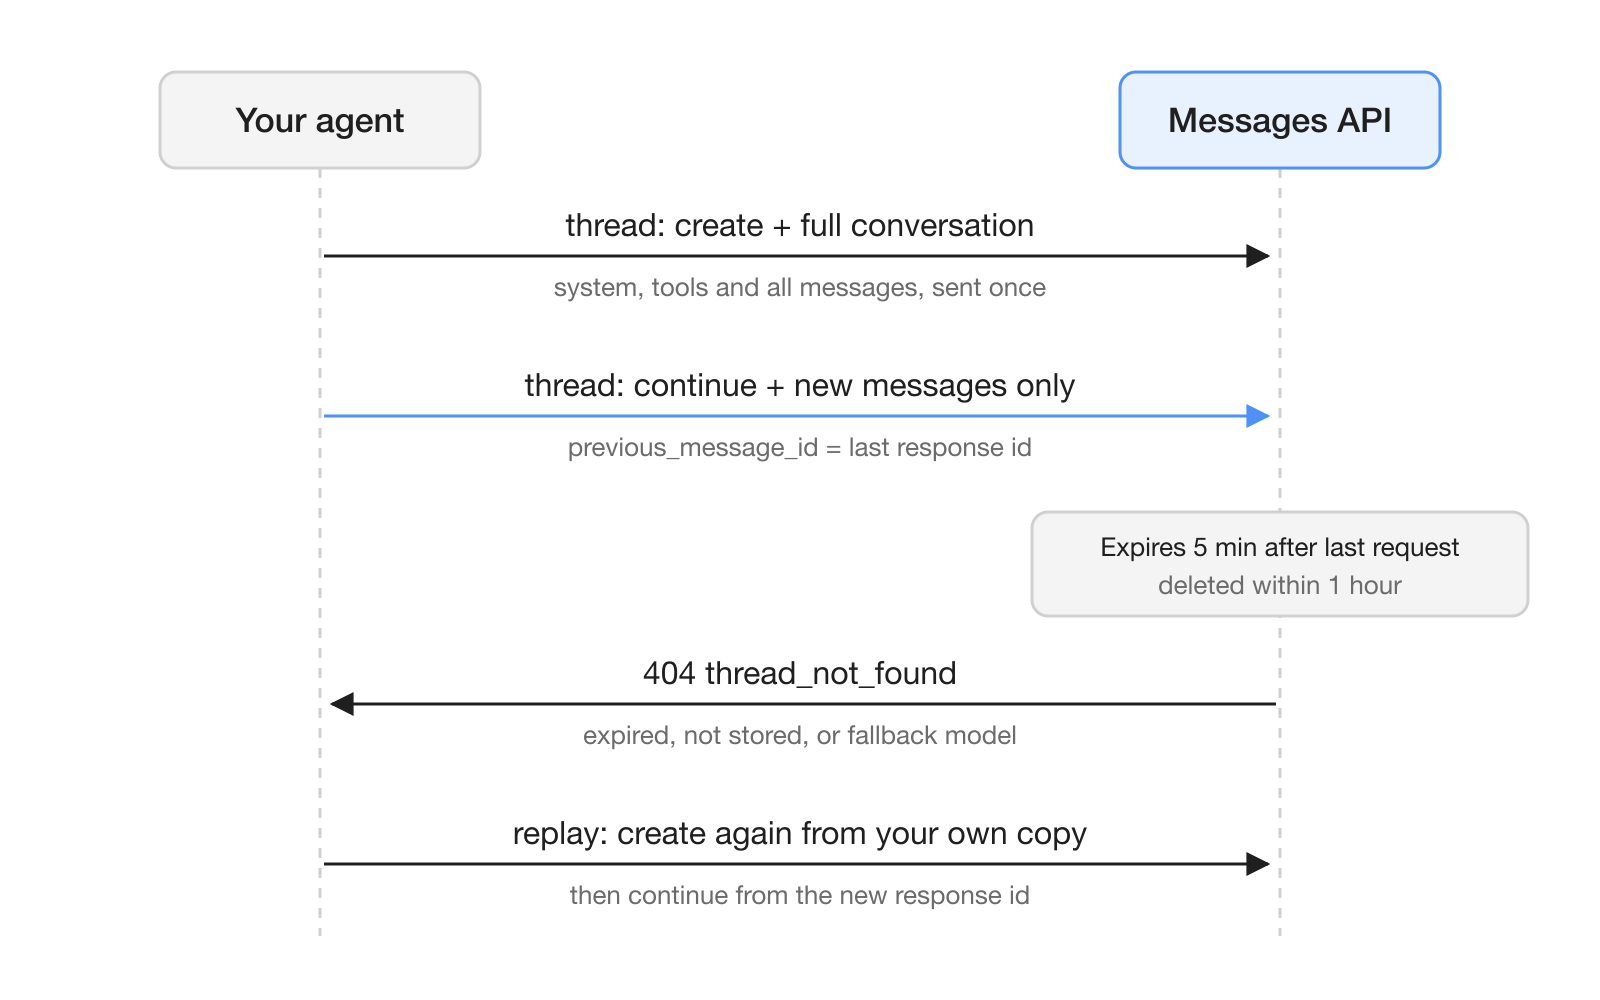
스레드는 최선 노력(best-effort) 방식이다. 스레드는 마지막 요청 5분 뒤 만료되고, 응답이 저장될 때마다 이 타이머가 다시 시작된다. API는 마지막으로 쓰인 지 1시간 안에 스레드를 지운다 [2][3]. API가 스레드를 이어 갈 수 없으면 continue 요청은 404 오류를 돌려주고, 이때는 새 create 요청으로 전체 대화를 다시 보낸다.
Claude는 턴마다 여전히 전체 대화를 읽는다. 그래서 토큰 사용량은 달라지지 않는다 [1]. 줄어드는 것은 네트워크로 오가는 양과 모델이 답을 시작하기 전에 API가 다시 처리해야 하는 양이고, 청구되는 토큰은 같다.
턴 사이에 바꿔도 되는 요청 필드는 무엇인가?
필드는 세 묶음으로 나뉜다. 이 구분을 틀리면 400 오류가 나기 쉽다 [2].
| 묶음 | 필드 | 규칙 |
|---|---|---|
| 생성 전용 | system, tools | create 요청에서만 보낸다. continue 요청에 둘 중 하나라도 보내면 null이라도 400이 돌아온다 |
| 고정 | model, tool_choice, thinking, mcp_servers(서버별 토큰은 제외), context_management, output_config, 컨테이너 skills, 최상위 cache_control, anthropic-beta 값의 집합 | 모든 요청에서 값이 같아야 한다. 다르면 400 thread_fingerprint_mismatch가 돌아온다 |
| 자유 | max_tokens, stop_sequences, stream, metadata, service_tier 등 나머지 필드 | 턴마다 바꿔도 된다 |
API는 MCP 서버 URL과 MCP 인가 토큰, 컨테이너 id를 저장하지 않는다. 그래서 mcp_servers와 container는 쓰는 요청마다 매번 보내야 한다 [2]. 작업 도중 모델을 바꿀 때처럼 생성 전용이나 고정 필드를 바꾸려면 전체 대화로 새 스레드를 시작해야 한다.
스레드에는 뒤에 덧붙이기만 할 수 있고, 응답 id 하나는 한 번만 이어 갈 수 있다 [2]. 앞선 메시지를 고치거나 갈래를 나누려면, 또는 기록을 요약으로 압축하려면 새 스레드를 시작해야 한다.
SDK에서는 메시지 스레드를 어떻게 쓰나?
일은 대부분 SDK의 스레드 헬퍼가 맡는다. 헬퍼는 베타 헤더를 붙이고, 첫 턴에는 전체 대화를, 그 뒤로는 새 메시지만 보낸다 [2]. 아래 Python 예제는 문서를 따른 것이다.
import anthropic

client = anthropic.Anthropic()

# Creating the helper sends no request.
thread = client.beta.messages.thread(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
)

# Turn 1 creates the thread with the full conversation.
thread.send({"role": "user", "content": "Hi, I have a question about an order."})

# Turn 2 continues it and sends only the new message.
second = thread.send(
    {"role": "user", "content": "How long does standard shipping usually take?"}
)

for block in second.content:
    if block.type == "text":
        print(block.text)
continue 요청이 thread_not_found, thread_already_continued, thread_continue_in_flight 중 하나를 돌려주면 헬퍼는 전체 대화를 한 번 다시 보낸다. pause_turn 응답은 이어서 처리하고, 모델이 답을 거절한 뒤에는 새 스레드를 시작한다 [2]. unsupported_request_behavior를 continue_unthreaded로 정해 두면, API가 대화를 저장할 수 없을 때 스레드 없는 일반 요청으로 돌아간다. SDK의 베타 툴 러너도 기본으로 스레드를 쓰며, 러너를 만들 때 이 동작을 끌 수 있다.
요청을 직접 만든다면 스레드의 모든 요청에 message-threads-2026-08-12 헤더를 붙여야 한다. 스트리밍을 쓸 때는 message_stop 이벤트가 온 뒤에만 이어 가야 한다. 그보다 먼저 보낸 continue 요청은 404를 돌려줄 수 있다 [2].
프롬프트 캐싱에는 여전히 중단점이 필요하다
스레드가 프롬프트를 대신 캐싱해 주지는 않는다 [2]. 턴마다 캐싱하려면 예제처럼 모든 요청에 같은 최상위 cache_control을 보낸다. 스레드 요청 하나에는 cache_control 중단점(breakpoint)을 최대 4개까지 둘 수 있고, 최상위 값도 하나로 센다. 하나라도 넘치면 thread_unsupported_request와 함께 400이 돌아온다.
AI 에이전트를 쓰는 팀에는 무엇이 달라지나?
팀 입장에서 메시지 스레드는 주로 장기 실행 에이전트의 응답 속도를 바꾸고, 비용은 그대로 둔다. Anthropic은 효과가 가장 큰 작업으로 세 가지를 꼽는다. 오래 도는 코딩 에이전트, 스크린숏을 다시 올리지 않고 스레드에 남겨 두는 컴퓨터 사용(computer use) 에이전트, 문서나 이미지가 많은 워크플로다 [1].
엔지니어링에서 가장 중요한 원칙은 애플리케이션이 원본 데이터의 주인으로 남아야 한다는 점이다. 문서는 모든 메시지의 사본을 직접 보관하고 재전송 경로를 처음부터 만들어 두라고 권한다. 어떤 응답도 API가 그 턴을 저장했는지 알려 주지 않기 때문이다 [2]. SDK 헬퍼는 사본을 메모리에만 두므로, 프로세스가 재시작돼도 대화가 남아 있어야 하거나 워커 사이를 옮겨 다니는 에이전트라면 저장소를 따로 둬야 한다.
여러 서비스가 에이전트 하나를 함께 움직일 때는 소유권도 따져야 한다. 스레드를 만든 쪽과 다른 조직, 워크스페이스, 사용자, 서비스 계정이 continue 요청을 보내면 thread_not_found가 돌아온다 [2]. 스레드 하나에는 API 키와 워크스페이스를 하나만 쓰고, Claude Platform on AWS에서는 같은 IAM 역할이나 사용자를 써야 한다.
어디서 쓸 수 있고, 무엇을 지원하지 않나?
메시지 스레드는 Claude API, Claude Platform on AWS, Claude Models on Google Cloud(Anthropic 관리형), Claude in Microsoft Foundry에서 베타로 쓸 수 있다 [2][3]. 문서는 현재 나와 있는 모든 모델을 지원 대상으로 올려 두었다. claude-sonnet-4-5-20250929부터 claude-fable-5-1, claude-mythos-5-1까지이고, claude-opus-5-5, claude-sonnet-5-5, claude-haiku-5-5도 들어 있다 [2].
다음 기능은 스레드와 함께 쓸 수 없다 [2].
- Message Batches와 토큰 계산은 쓸 수 없다. 토큰은 전체 대화로 따로 센다.
- 요청 시 압축을 포함한 압축(compaction)과 컨텍스트 편집은 쓸 수 없다. 단,
keep: "all"을 지정한clear_thinking_20251015는 예외다. - HIPAA 대비(HIPAA readiness)나 추론 훅(inference hooks)을 켠 조직은 쓸 수 없다.
한계와 남은 질문은?
이번 베타에는 스레드를 나열하거나 읽거나 지우는 API가 없다 [2]. 이어 갈 수 없는 스레드에 돌아오는 404는 이유를 알려 주지 않는다. 원인으로는 만료, API가 응답은 했지만 저장하지 않은 턴, 대체(fallback) 모델이 쓴 응답, 이미지가 없던 대화에 처음 추가된 이미지 등이 있다. Claude API에서는 서버 측 대체 기능이 스레드와 함께 동작하지만, 둘을 같이 쓰면 thread_unsupported_request 오류를 받는 조직도 있다. 대체 모델이 처리한 턴은 저장되지 않으므로, 고정 라우팅(sticky routing)을 쓰면 에이전트가 턴마다 전체 대화를 보내게 될 수도 있다 [2].
35%라는 수치는 500k~1M 토큰 규모의 Claude Code에서 나온 값이다 [1]. Anthropic은 더 짧은 대화의 수치를 공개하지 않았다. 특정한 개선 폭을 기대하기 전에 자기 트래픽에서 첫 토큰까지 걸리는 시간을 직접 재 봐야 한다. 발표문과 문서는 이 기능이 언제 베타를 벗어날지도 밝히지 않는다.
자주 묻는 질문
Claude 메시지 스레드를 쓰면 토큰 비용이 줄어드나?
줄지 않는다. Claude는 턴마다 여전히 전체 대화를 읽으므로 토큰 사용량은 같고, Anthropic 문서도 스레드가 가격과 속도 제한을 바꾸지 않는다고 밝힌다. 얻는 것은 요청이 작아져 첫 토큰까지 걸리는 시간이 줄어든다는 점이다.
Claude 메시지 스레드는 얼마 동안 유지되나?
스레드는 마지막 요청 5분 뒤 만료되고, 응답이 저장될 때마다 이 타이머가 다시 시작된다. API는 마지막으로 쓰인 지 1시간 안에 스레드를 지운다.
continue 요청이 thread_not_found를 돌려주면 에이전트는 어떻게 해야 하나?
직접 보관한 사본에서 전체 대화를 꺼내 system, tools와 함께 새 create 요청으로 보내고, 새 응답 ID로 이어 가면 된다. SDK의 스레드 헬퍼는 이 재전송을 한 번 알아서 한다.
메시지 스레드 도중에 모델이나 툴을 바꿀 수 있나?
바꿀 수 없다. system과 tools는 create 요청에서만 정하고, model, thinking, tool_choice 같은 필드는 모든 요청에서 같아야 한다. 다르면 API가 thread_fingerprint_mismatch를 돌려준다. 바꾸려면 새 스레드를 시작해야 한다.
Claude 메시지 스레드는 데이터 무보관(ZDR) 대상인가?
대상에서 빠진다. 메시지 스레드는 데이터 무보관(ZDR)과 HIPAA 모두 적용되지 않는다. API는 스레드를 서버가 관리하는 키로 암호화해 메모리에만 두고, 영구 저장소에는 절대 쓰지 않는다.