Gemini 2.5 Pro와 Flash 지원 종료, 12월 1일 전에 에이전트를 옮기는 방법
2026년 12월 1일부터 Gemini 2.5 Pro와 2.5 Flash 호출이 3.8 Flash와 3.5 Flash-Lite로 자동 전환되므로, 그 전에 에이전트를 옮기는 방법을 정리했다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- Google은 2026년 11월 2일 Gemini 2.5 Pro와 2.5 Flash 모델을 지원 중단 대상으로 지정했다.
- 2026년 12월 1일부터는 코드를 그대로 두어도 2.5 Pro 호출은 3.8 Flash가, 2.5 Flash 호출은 3.5 Flash-Lite가 자동으로 받아 처리한다.
- 자동 전환된 요청에는 새 모델 요금이 붙고, 2.5 Flash-Lite는 지원 중단 대상이 아니다.
- Gemini 3 모델은 thinking_budget 설정, 샘플링 파라미터, 미리 채운 모델 턴을 더는 지원하지 않는다.
이 글의 차례
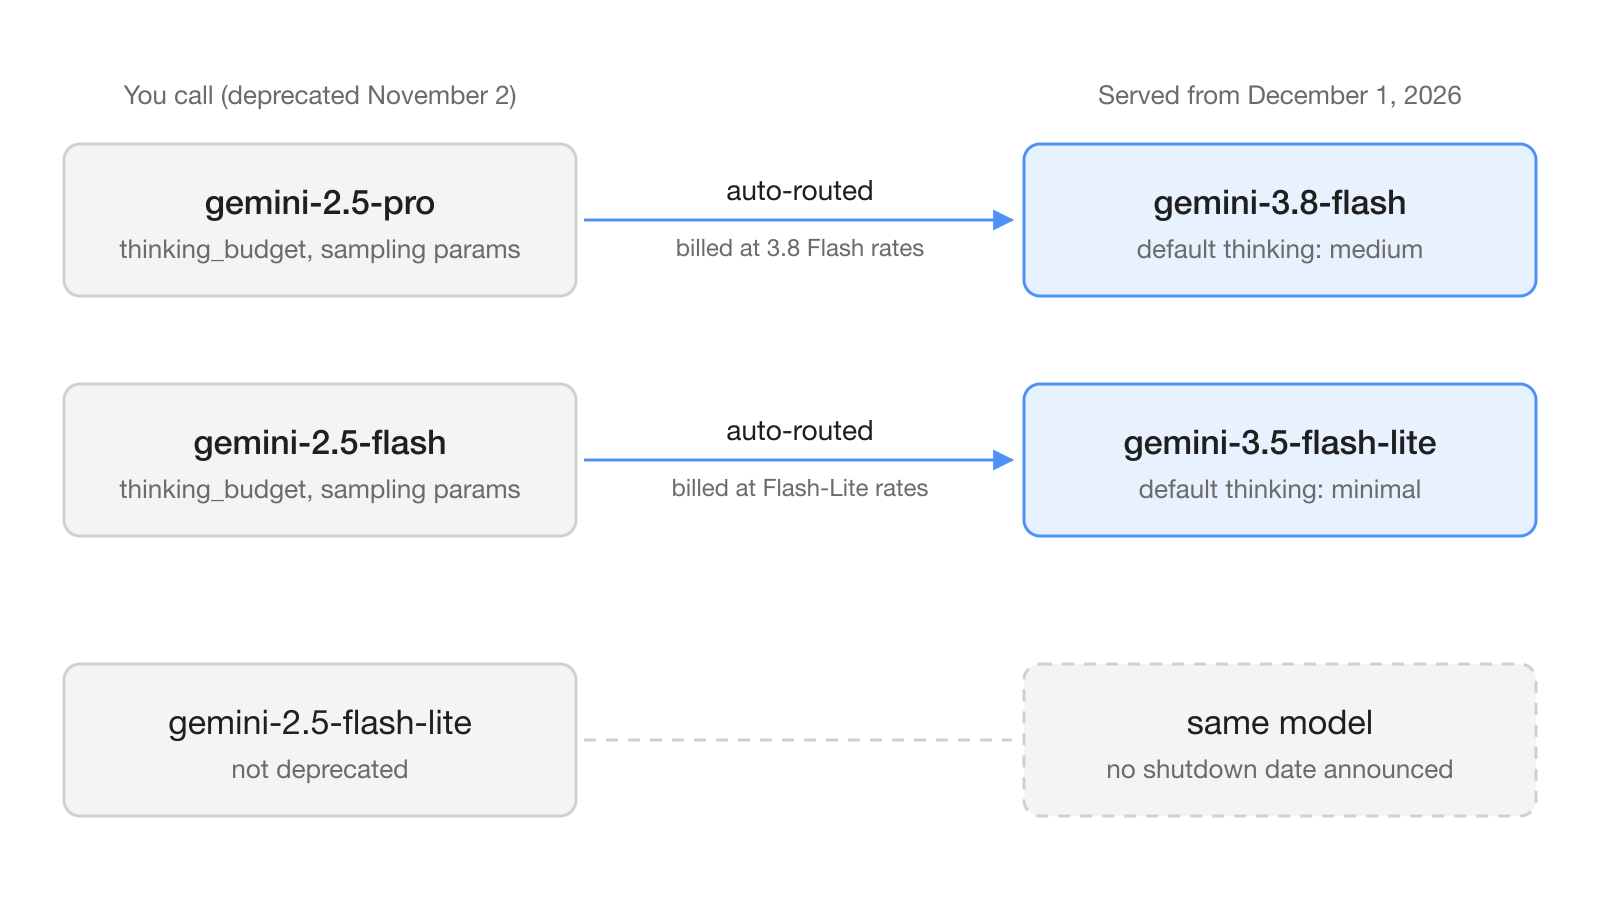
Google은 2026년 11월 2일 Gemini API의 gemini-2.5-pro와 gemini-2.5-flash를 지원 중단했다. 2026년 12월 1일부터 두 모델 요청은 각각 gemini-3.8-flash와 gemini-3.5-flash-lite로 자동 전환되고, 새 모델 요금으로 청구된다 [1]. 모델을 직접 고르려면 그 전에 에이전트를 옮겨야 한다. 모델 문자열을 바꾸고, thinking_level로 전환하고, 샘플링 파라미터와 미리 채운 모델 턴을 없애면 된다.
11월 2일에 무엇이 바뀌었나?
Google은 두 모델을 지원 중단 상태로 바꿨고, 이제 Google AI Studio에서는 두 모델을 고를 수 없다 [1]. 지원 중단 페이지를 보면 지금은 이 모델을 써 본 적이 있는 기존 사용자만 접근할 수 있다. 같은 페이지는 두 모델의 서비스 종료일을 2026년 12월 1일로 밝힌다 [2].
서비스가 종료돼도 오류가 나지는 않는다. 엔드포인트는 계속 응답하지만, 답을 보내는 모델이 바뀐다.
| 호출하는 모델 | 2026년 12월 1일부터 답하는 모델 | 청구 기준 |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Gemini 3.8 Flash 요금 |
gemini-2.5-flash | gemini-3.5-flash-lite | Gemini 3.5 Flash-Lite 요금 |
gemini-2.5-flash-lite | 변동 없음 | 변동 없음 |
gemini-2.5-flash-lite는 지원 중단 대상이 아니고, 종료일도 발표되지 않았다 [2]. Google은 이 페이지에 적힌 종료일을 "가장 이른 시점"이라고 부르며, 정확한 날짜는 미리 공지한 뒤 발표하겠다고 밝힌다.
변경 기록(changelog)은 이번 전환에 호환성을 깨는 변경이 따른다고 경고한다. 함수 호출(function calling)과 thought_signature의 검증 방식이 바뀌고, thinking_level이 thinking_budget을 대신하며, 샘플링 파라미터와 미리 채운 모델 턴은 사라진다 [1].
음성 에이전트에는 더 이른 마감이 따로 있다. gemini-2.5-pro-preview-tts와 gemini-2.5-flash-preview-tts는 2026년 11월 17일에 종료된다. 대체 모델은 gemini-3.8-flash-tts 또는 gemini-3.8-flash-lite-tts다 [2].
자동 전환이 에이전트에 왜 위험한가?
코드는 그대로인데 모델과 기본값, 검증 규칙이 한꺼번에 바뀌기 때문이다. 11월 30일에 잘 돌던 에이전트가 12월 1일에는 다르게 동작할 수 있고, 우리 쪽 배포 기록으로는 그 변화를 설명할 수 없다.
에이전트 루프에서는 세 가지 차이가 특히 중요하다.
- 사고 기본값. Gemini 3.8 Flash는 기본 사고 수준이
medium이고low,medium,high를 받는다.minimal은 지원하지 않으며, 이 값을 보내면 오류가 난다 [4]. Gemini 3.5 Flash-Lite의 기본값은minimal이다 [5]. Google은 툴을 쓰거나 코드를 실행하거나 여러 단계에 걸쳐 추론하는 자율 하위 에이전트에는 작업이 일찍 끝나지 않도록medium이나high를 권한다. - 미리 채운 턴. Gemini 3 모델에서는 비어 있지 않은 마지막 턴이
model턴인 요청이 HTTP 400 오류를 받는다 [5]. 형식을 강제하려고 모델 답의 앞부분을 미리 채우던 에이전트는 다른 방법을 찾아야 한다. - 샘플링 파라미터. API는 현재
temperature,top_p,top_k를 무시한다. Google은 앞으로 나올 모델 세대에서는 이 값들이 오류를 낸다고 밝힌다 [5]. 매번 같은 출력을 얻으려고temperature: 0에 기대던 에이전트는 그 통제 수단을 잃는다.
변경 기록은 thinking_budget을 그대로 담은 채 전환된 요청을 정확히 어떻게 처리할지 밝히지 않는다. 3.6 가이드도 이 값을 바꾸라고만 안내한다 [5]. Gemini 2.5에서와 같은 효과는 없다고 보고 대비하는 편이 안전하다.
가격은 어떻게 달라지나?
gemini-2.5-flash 트래픽은 텍스트 가격이 그대로다. Gemini 2.5 Flash는 텍스트, 이미지, 동영상 입력이 100만 토큰(1M)당 0.30달러이고 출력은 100만 토큰당 2.50달러다. Gemini 3.5 Flash-Lite도 똑같이 0.30달러와 2.50달러다 [3]. 오디오 입력은 오히려 싸진다. 2.5 Flash에서 1.00달러였던 가격이 3.5 Flash-Lite에서는 0.30달러다.
gemini-2.5-pro 트래픽은 시기에 따라 답이 다르다. Gemini 2.5 Pro는 200k 토큰 이하 프롬프트에서 100만 토큰당 입력 1.25달러, 출력 10.00달러이고, 그보다 길면 2.50달러와 15.00달러다 [3]. Gemini 3.8 Flash는 2026년 12월 31일까지 입력 0.75달러, 출력 3.75달러의 출시 할인 가격을 받는다. 2027년 1월 1일부터 표준 가격은 입력 1.50달러, 출력 7.50달러다 [4].
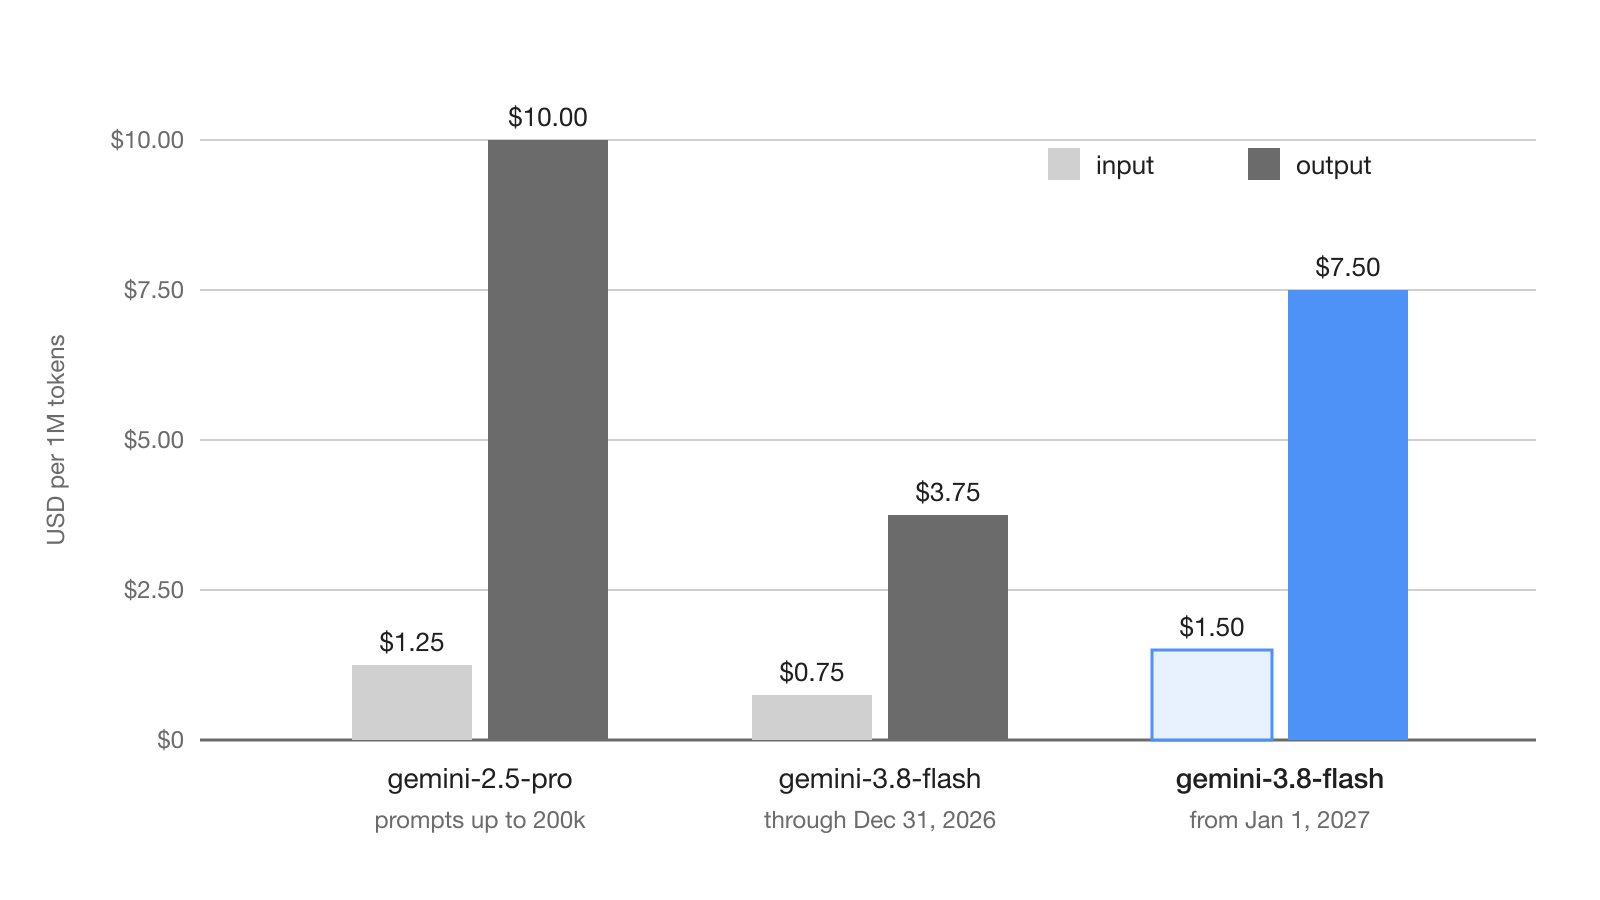
공개된 요금으로 계산하면 전환된 Pro 트래픽은 2026년 12월에는 비용이 줄어든다. 2027년 1월부터는 짧은 프롬프트의 입력 토큰이 2.5 Pro보다 비싸지고(1.50달러 대 1.25달러), 출력 토큰은 싸진다(7.50달러 대 10.00달러). 턴마다 긴 컨텍스트를 다시 보내는 에이전트 루프는 토큰 대부분이 입력이다. 청구액이 줄어든다고 단정하기 전에 자기 서비스의 입력 대 출력 비율부터 확인해야 한다. 이 모델들에서는 사고 토큰도 출력으로 계산된다 [3]. 그래서 3.8 Flash의 더 높은 기본 사고 수준이 출력 토큰을 늘릴 수 있다.
Gemini 2.5에서 에이전트를 어떻게 옮기나?
먼저 옮겨 갈 모델을 직접 정하고, 그 모델에 맞는 Google 체크리스트를 하나씩 따른다. 기본 대상은 자동 전환되는 모델이지만, 다른 모델을 골라도 된다. 라우터가 정한 모델이 아니라 자체 평가 결과가 뒷받침하는 모델을 골라야 한다.
Gemini 3.8 Flash 체크리스트는 6단계다 [4].
- 모델 ID를
gemini-3.8-flash로 바꾼다. thinking_budget을thinking_level(low,medium,high)로 바꾼다.temperature,top_p,top_k,candidate_count와 미리 채운 모델 턴을 없앤다.- 여러 턴에 걸친 대화는
previous_interaction_id로 서버 쪽에서 관리한다. - 함수 호출을 점검한다. 멀티모달 자료는 함수 응답 페이로드 안에 넣고, 인라인 지시문은
\n\n줄바꿈으로 나눈다. generateContent API에서는 모든FunctionResponse에call_id와name이 함께 들어 있는지 확인한다. - Gemini 3 기본 요건을 적용한다. SDK를 업데이트하고 사고 서명(thought signature)을 보존한다.
Gemini 3.5 Flash-Lite의 단계도 사고 수준만 빼면 같다. 대량 추출, 라우팅, 분류 작업에는 minimal을 유지하고, 툴을 쓰는 하위 에이전트에는 medium이나 high를 쓴다 [5]. Google은 마이그레이션을 자동으로 해 주는 에이전트 스킬도 공개했다.
npx skills add google-gemini/gemini-skills --skill gemini-interactions-api --global미리 채운 턴을 대신하려면 형식 지시를 system_instruction으로 옮긴다. Google 가이드는 Interactions API에서 이 방식을 보여 준다 [5].
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.5-flash-lite",
    input="Translate 'Hello world' to Spanish.",
    system_instruction="Output only the translation without introductory text.",
    generation_config={"thinking_level": "medium"},
)
툴 루프의 사고 서명
에이전트가 대화 기록을 직접 관리한다면 사고 서명에 신경 써야 한다. store: true와 previous_interaction_id를 쓰는 상태 유지(stateful) 모드에서는 서버가 사고 블록과 서명을 알아서 관리한다 [6]. 상태 비유지(stateless) 모드에서는 모델이 돌려준 thought 블록을 지우거나 고치지 말고 받은 그대로 모두 다시 보내야 한다. 모델을 바꿀 때도 마찬가지다. Google 검색 같은 내장 툴의 서명도 다시 보내야 한다.
AI 에이전트를 운영하는 팀에는 무엇이 달라지나?
예정된 배포가 없더라도 팀은 2026년 12월 1일을 모델 교체일로 다뤄야 한다. 먼저 gemini-2.5-pro나 gemini-2.5-flash를 지정한 곳을 모두 찾는다. 주 애플리케이션뿐 아니라 예약 작업, 평가 하네스, 로우코드 자동화, 누군가 한 번 설정하고 잊어버린 에이전트 설정까지 살펴야 한다.
그다음 전환일 전에 대상 모델로 에이전트 평가를 다시 돌린다. 지켜볼 점은 세 가지다. minimal 사고 수준의 Flash-Lite에서 일찍 끝나 버리는 작업, 미리 채운 턴이나 temperature로 안정시키던 출력 형식이 흐트러지는 문제, 그리고 2027년 1월 가격이 적용된 뒤의 작업당 비용이다. 여러 에이전트가 한 워크스페이스를 함께 쓴다면 같은 날 한꺼번에 바꿔야 한다. 그래야 에이전트끼리 작업을 넘길 때 2.5 모델과 3.x 모델의 출력이 아무도 모르게 섞이지 않는다.
한계와 남은 질문은?
아직 분명하지 않은 부분도 있다. 지원 중단 페이지는 2026년 12월 1일을 가장 이른 종료 시점이라고 부르고, 정확한 날짜는 미리 알리겠다고 약속한다 [2]. 자동 전환 날짜가 바뀔 여지가 남아 있다는 뜻이다. 가이드는 thinking_budget이나 candidate_count를 여전히 보내는 전환 요청을 거부하는지 무시하는지 밝히지 않고, 미리 채운 턴에 돌아오는 정확한 오류 본문도 보여 주지 않는다 [5].
전환 대상도 Google이 대신 내린 판단이다. Pro 트래픽을 Flash 모델로, Flash 트래픽을 Flash-Lite 모델로 옮기면 모델 등급이 바뀐다. 여기서 인용한 마이그레이션 가이드는 기존 모델과 전환 대상 모델의 품질을 비교하지 않는다. 12월 1일 전에 믿을 수 있는 확인 수단은 자체 평가뿐이다.
자주 묻는 질문
2026년 12월 1일 이후 gemini-2.5-pro를 호출하면 어떻게 되나?
호출이 거부되지는 않는다. Google이 요청을 gemini-3.8-flash로 자동 전환하고 Gemini 3.8 Flash 요금으로 청구하므로, 기본값이 다른 별개의 모델이 답을 보낸다.
Gemini 2.5 Flash를 대신하게 되는 모델은 무엇인가?
2026년 12월 1일부터 gemini-2.5-flash 요청은 3.5 Flash-Lite 모델로 넘어가고, 요금도 3.5 Flash-Lite 기준으로 청구된다. 텍스트 가격은 100만 토큰당 입력 0.30달러, 출력 2.50달러로 두 모델이 같다.
2.5 Flash-Lite 모델도 함께 서비스가 종료되나?
아니다. Gemini API 지원 중단 페이지는 gemini-2.5-flash-lite를 지원 중단 대상이 아닌 모델로 분류하고, 종료 날짜도 발표되지 않았다.
3.8 Flash 모델에서도 온도(temperature)와 사고 예산 설정이 그대로 동작하나?
동작하지 않는다. Google의 마이그레이션 가이드는 thinking_budget을 thinking_level로 바꾸고 샘플링 파라미터인 temperature, top_p, top_k를 없애라고 안내한다. API는 지금 이 값들을 무시하지만, 앞으로 나올 모델 세대에서는 요청을 거부하게 된다.
자동 전환된 gemini-2.5-pro 트래픽의 비용은 늘어나나, 줄어드나?
Gemini 3.8 Flash는 2026년 12월 31일까지 100만 토큰당 입력 0.75달러, 출력 3.75달러이고, 그 뒤로는 1.50달러와 7.50달러다. Gemini 2.5 Pro는 200k 토큰 이하 프롬프트 기준 1.25달러와 10.00달러여서, 입력 비중이 큰 에이전트는 2027년 1월부터 비용이 더 들 수 있다.