Gemini 4 Hydrogen 출시, 에이전트를 3.8 Flash에서 옮기려면 무엇을 바꿔야 하나?
2026년 11월 12일 출시된 Gemini 4 Hydrogen은 100만 토큰당 입력 $1.50, 출력 $7.50이고, 3.8 Flash에서 옮기는 에이전트는 명시적 캐싱을 빼야 한다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- Gemini 4 Hydrogen은 2026년 11월 12일부터 Gemini API에서 안정판 모델로 순차 출시되기 시작했다.
- 가격은 100만 토큰당 입력 $1.50, 출력 $7.50이고, 컨텍스트 창은 100만 토큰이다.
- 구글은 이 모델의 Terminal-Bench 4.1 점수가 57%로, 3.8 Flash의 18.2%보다 높다고 밝혔다.
- 3.8 Flash에서 옮기려면 명시적 캐싱을 빼고, 새 기본값인 high 사고 수준을 시험해야 한다.
이 글의 차례
Gemini 4 Hydrogen은 구글이 빠른 일상 에이전트 작업용으로 내놓은 새 모델이다. 모델 ID는 gemini-4-hydrogen이고 안정판이며, 2026년 11월 12일부터 Gemini API에 차례로 배포되고 있다 [1][4]. 가격은 100만 토큰당 입력 $1.50, 출력 $7.50이고, 구글은 Gemini 3.8 Flash에서 올라갈 모델로 이 모델을 권한다 [3]. 에이전트를 옮기려면 모델 ID를 바꾸고, 가이드에 나온 나머지 이전 단계도 밟아야 한다.
Gemini 4 Hydrogen은 어떤 모델인가?
Hydrogen은 Gemini 4 제품군에서 실행을 맡는 모델이다. 구글은 이 모델을 "에이전트 워크플로의 일상용 모델"이라고 부른다. 같은 제품군의 Carbon과 Argon은 길고 깊은 추론을 맡는 최상위 모델이고, Hydrogen은 빠른 실행에 맞춰 만들었다 [1]. 이 모델은 혼자 쓸 수도 있고, Carbon이나 Argon 옆에 실행 엔진으로 붙여 쓸 수도 있다.
개발자용 발표 글은 주요 작업으로 저장소 단위의 코딩과 디버깅, 대화형 웹 개발, 멀티모달 워크플로를 꼽는다 [2]. 이전 가이드에 따르면 이 모델은 읽기와 검색 툴 호출을 병렬로 묶어 처리하고, 툴 호출이 실패했을 때도 더 잘 대처한다 [3].
모델 카드가 밝힌 기술 사양은 다음과 같다 [4].
| 항목 | 내용 |
|---|---|
| 모델 ID | gemini-4-hydrogen (안정판만 있음) |
| 입력 | 텍스트, 이미지, 동영상, 오디오, PDF |
| 출력 | 텍스트 |
| 컨텍스트 창 | 1,048,576 토큰, 입력과 출력이 함께 쓴다 |
| 최대 출력 | 동기 호출은 65,536 토큰, 긴 디코딩을 쓰면 최대 1,048,576 토큰 |
| 사고 수준 | low, medium, high, xhigh |
| 툴 | 함수 호출, 코드 실행, 컴퓨터 사용, 파일 검색, URL 컨텍스트, 구글 검색과 구글 지도 그라운딩, 구조화된 출력 |
| 지원하지 않음 | 이미지 생성, 오디오 생성, Live API |
| 이용 방식 | Batch API, Flex 추론, Priority 추론 |
Gemini 3.8 Flash, Argon과 비교하면 어떤가?
구글 발표에 따르면 Hydrogen은 기본값인 높음(high) 설정에서 3.8 Flash보다 작업을 2.5배 빨리 끝낸다. Terminal-Bench 4.1 점수는 57%로 3.8 Flash의 18.2%를 크게 앞서고, 사실이 아닌 주장을 지어내는 일은 5배 넘게 줄었다 [1]. 이전 가이드는 지어낸 주장이 줄어든 이유로, 모델이 짐작하는 대신 빠진 맥락을 먼저 알린다는 점을 든다 [3]. 이 수치는 모두 구글이 직접 잰 값이다.
구글이 밝힌 Artificial Analysis Intelligence Index 점수를 보면, 이 모델은 기본 수준인 high에서 51점으로 Argon의 50점과 비슷하다. 가장 높은 xhigh에서는 54점이다 [1]. 모델 라우팅을 짤 때 이 점이 중요하다. 이 지수로 보면 더 싼 모델이 더 비싼 장기 작업용 모델과 같은 수준이기 때문이다.
에이전트 운영자가 두 번 읽어야 할 숫자는 안전 수치다. 구글은 3.8 Flash와 비교해 이 모델이 에이전트 작업에서 맡은 범위를 넘어서는 행동을 최대 81% 줄였고, 작업이 막혔을 때 권한 경계를 우회할 가능성도 최대 2배 낮다고 밝혔다 [1]. 발표 글은 이 수치의 바탕이 된 평가 세트를 공개하지 않았다. 따라서 이 수치는 자체 권한 테스트를 대신할 근거가 아니라, 테스트를 다시 돌려 볼 이유로 받아들여야 한다.
Gemini 4 Hydrogen의 가격은 얼마인가?
표준 유료 등급 가격은 100만 토큰당 입력 $1.50, 출력 $7.50이다. 사고 토큰은 출력으로 과금하고, 100만 토큰 컨텍스트 전 구간에서 가격이 같다 [1][5]. 암시적 캐싱으로 캐시된 입력은 100만 토큰당 $0.075다. 무료 등급은 돈이 들지 않지만 사용량 한도가 있다 [3].
주변 모델과 비교한 결과는 날짜에 따라 달라진다. 가격 변경 두 건이 이미 예정돼 있기 때문이다 [5].
| 모델(표준 등급, 100만 토큰당) | 입력 | 출력 | 예정된 변경 |
|---|---|---|---|
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 공지된 변경 없음 |
| Gemini 3.8 Flash | $0.75 | $3.75 | 2027년 1월 1일부터 $1.50 / $7.50 |
| Gemini 4 Hydrogen | $1.50 | $7.50 | 공지된 변경 없음 |
| Gemini 4 Argon | $2.00 | $10.00 | 2026년 12월 1일부터 $4.00 / $20.00 |
| Gemini 4 Carbon | $2.00 | $10.00 | 2026년 12월 1일부터 $4.00 / $20.00 |
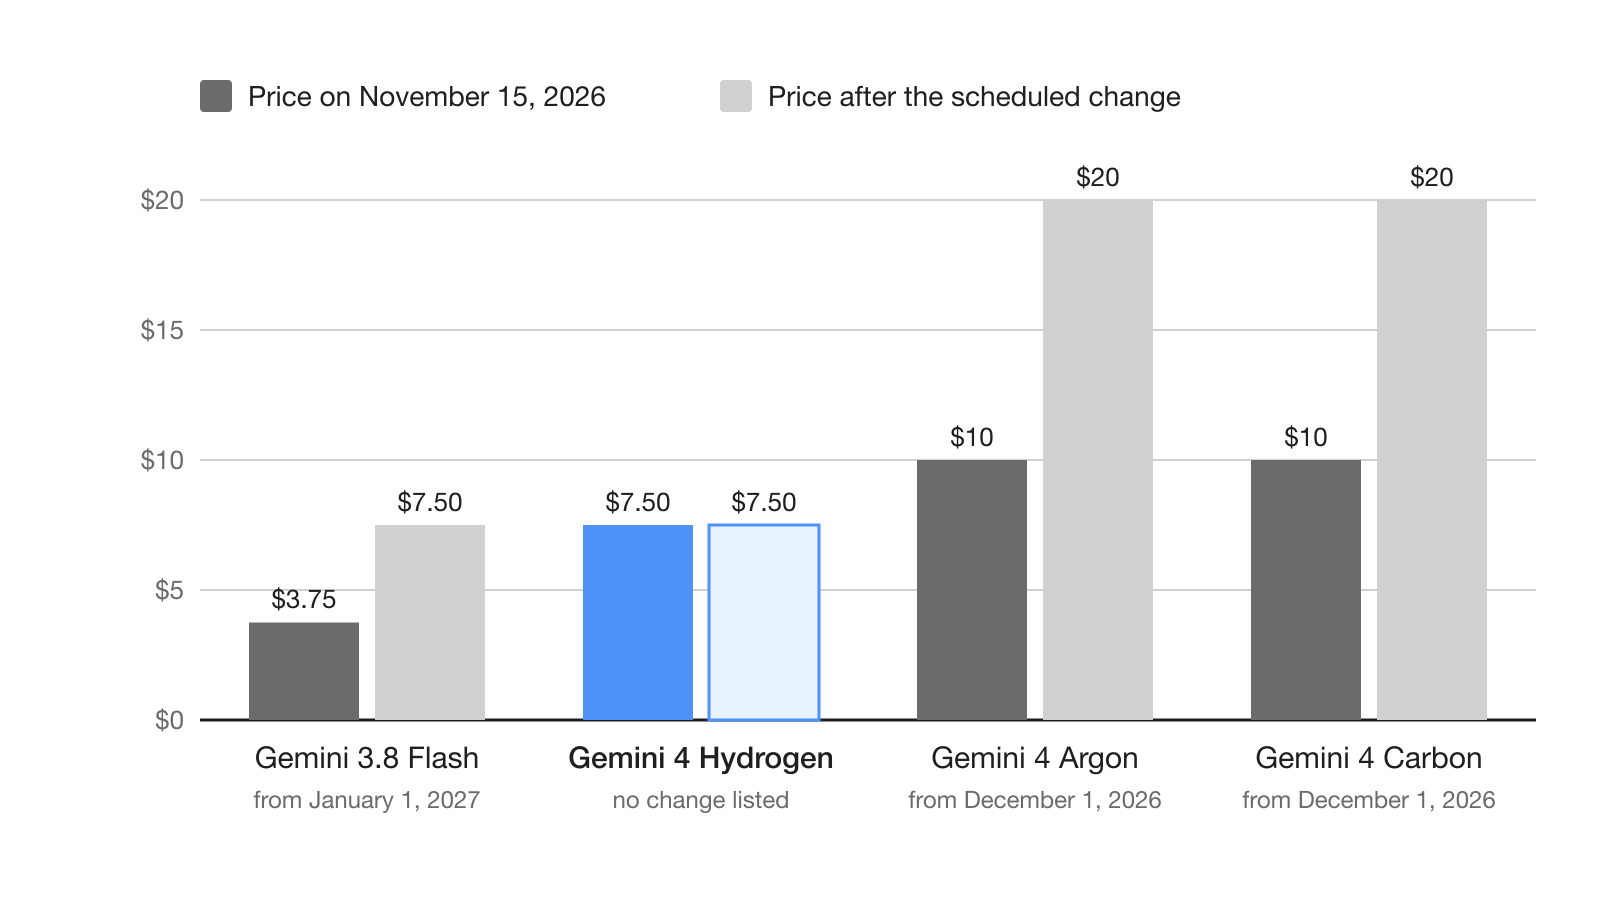
2027년 1월 1일부터는 3.8 Flash와 Hydrogen의 정가가 같아진다. 3.8 Flash에 남아서 비용을 아낄 수 있는 기간은 2026년 말까지다 [5]. 일괄 처리(Batch)와 Flex를 쓰면 이 모델의 가격이 절반인 입력 $0.75, 출력 $3.75로 내려가고, 우선 처리(Priority)를 쓰면 입력 $2.70, 출력 $13.50으로 오른다.
Gemini 3.8 Flash에서 에이전트를 어떻게 옮기나?
이전 가이드는 모델 ID부터 시작해, 이름만 바꾸면 잘 돌던 에이전트가 깨질 수 있는 변경을 차례로 짚는다 [3]. 새 모델은 GenerateContent와 Interactions API 양쪽에서, 무료와 유료 등급 모두에서 동작한다. 아래 요청 변경 말고도 가이드에는 100만 토큰 컨텍스트 창, 대화 상태와 사고 서명, 긴 출력을 위한 백그라운드 실행, 과금 점검 단계가 있다 [3].
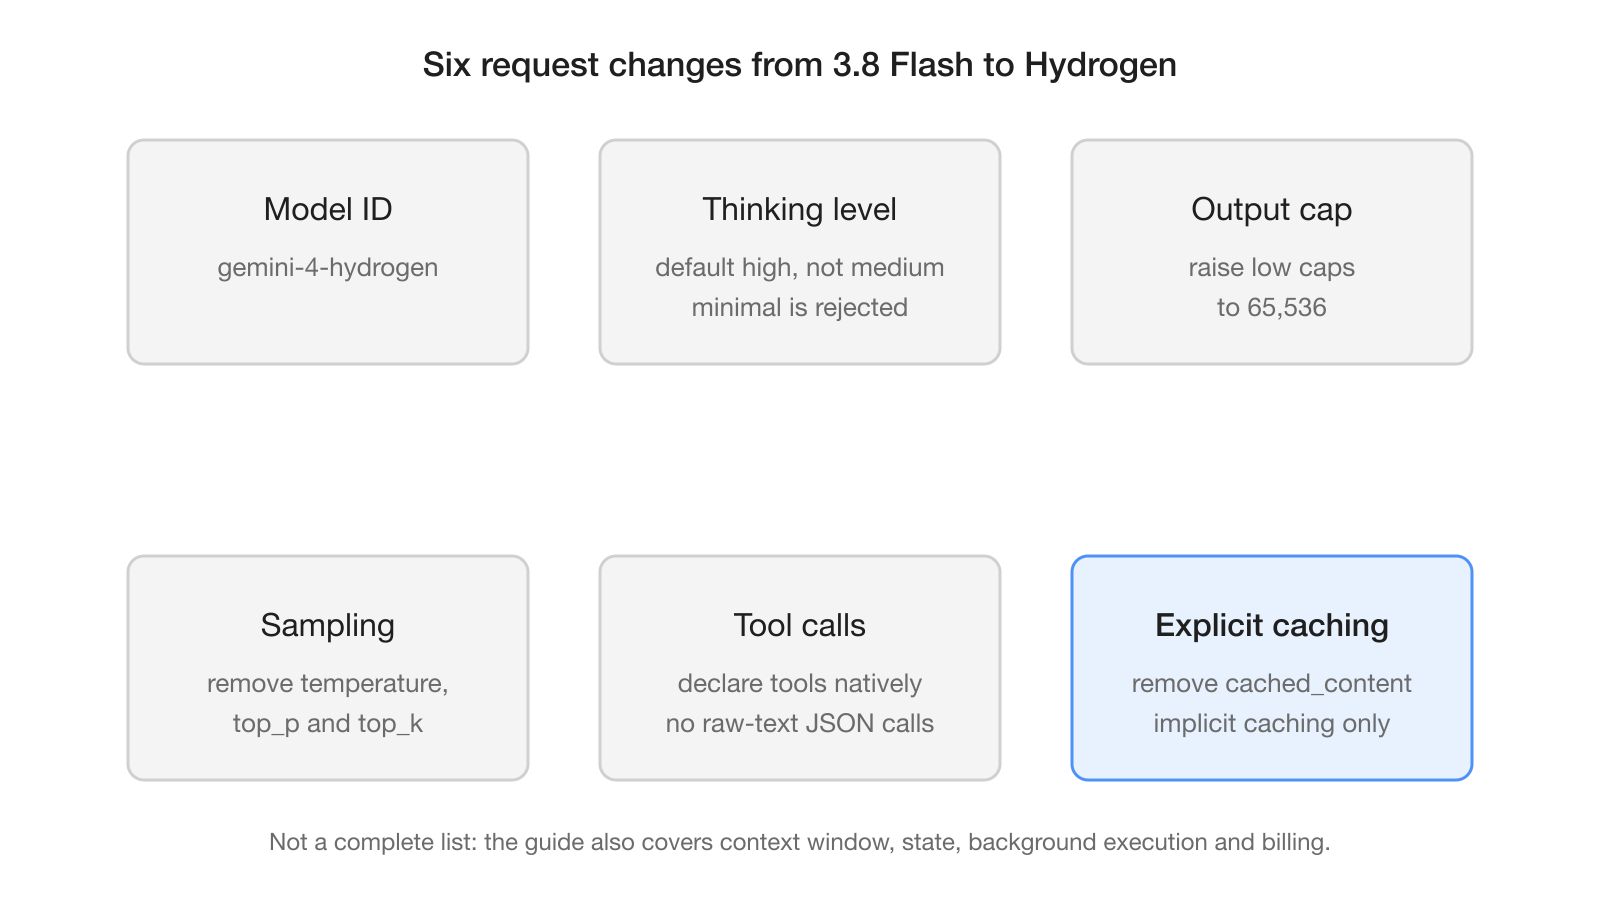
| 확인할 항목 | 3.8 Flash에서 하던 방식 | 새 모델에서 바뀌는 점 |
|---|---|---|
| 모델 ID | gemini-3.8-flash | gemini-4-hydrogen |
| 사고 수준 | 기본값 medium | 기본값 high, minimal은 오류로 거부된다 |
| 출력 상한 | 낮게 고정한 max_output_tokens | 상한을 없애거나 65,536으로 올린다 |
| 캐싱 | cached_content, cachedContents, caches.create | 명시적 캐싱은 지원하지 않는다. 해당 필드를 지우고 암시적 캐싱에 맡긴다 |
| 툴 호출 | 툴을 선언하지 않고 프롬프트로 날것의 텍스트 JSON을 요청 | 함수 호출로 툴을 선언하거나 구조화된 출력을 쓴다. 그러지 않으면 MALFORMED_FUNCTION_CALL이 나올 수 있다 |
| 샘플링 | 온도(temperature), top_p, top_k를 직접 지정 | 모두 지운다. 범위를 벗어난 값은 400 오류를 돌려준다 |
에이전트가 대화 기록을 직접 관리한다면 두 가지를 지켜야 한다. 이전 모델 응답과 사고 서명은 손대지 말고 그대로 돌려보내고, 사고 서명 하나를 병렬 함수 호출(functionCall) 파트 여러 개에 복사해 넣지 않는다 [3]. Interactions API를 쓴다면 이 작업 대신 previous_interaction_id가 여러 턴 세션과 툴 호출 세션의 상태를 유지한다.
기본값이 medium에서 high로 바뀌므로, 가이드는 평가 세트에서 두 수준을 모두 시험해 보라고 권한다. xhigh는 지연 시간과 토큰을 늘리므로 어려운 다단계 문제에만 쓰라고 한다 [3].
긴 출력
동기 호출은 스트리밍 여부와 상관없이 한 번의 호출에서 최대 65,536 토큰을 돌려준다 [3]. 더 긴 출력이 필요하면 background: true와 65,536보다 큰 출력 상한(max_output_tokens)을 지정하고, 상태가 진행 중(in_progress)이나 대기 중(queued)에서 벗어날 때까지 interactions.get을 주기적으로 조회한다. 출력 상한을 따로 지정하지 않은 백그라운드 요청은 여전히 65,536 토큰에서 멈춘다. 긴 보고서나 큰 파일을 생성하려면 상한을 꼭 지정해야 한다.
Carbon이나 Argon에서 옮길 때
Carbon이나 Argon이 하던 일 일부를 Hydrogen으로 내려보낸다면 요청 스키마는 그대로이고 모델 ID만 바뀐다 [3]. 동작이 다른 점은 두 가지다. Hydrogen의 기본값은 high이지만, Carbon과 Argon은 기본값이 medium이고 최대가 high다. 스트리밍하지 않는 REST 호출 한 번의 출력 한도도 Hydrogen은 65,536 토큰, 나머지 두 모델은 32,768 토큰으로 다르다.
AI 에이전트를 운영하는 팀에는 무엇이 달라지나?
팀 입장에서 Hydrogen은 2단 구성을 기본 패턴으로 만든다. 최상위 모델이 계획을 세우고, 더 싼 모델이 실행하는 방식이다. 구글이 직접 만든 예는 Google Antigravity의 Orchestrator로, Hydrogen과 Carbon을 짝지어 쓴다 [2]. 구글은 Terminal-Bench 4.0에서 Orchestrator가 Carbon에 가까운 작업 성공률을 내면서도 할당량은 24% 덜 쓰고 작업은 19% 더 빨리 끝냈다고 밝혔다 [1]. 관리형 에이전트(Managed Agents)의 Antigravity 에이전트도 이제 기본 모델로 Hydrogen을 쓴다 [3].
GitHub Copilot을 쓰는 팀은 API를 건드리지 않고도 이 모델을 쓸 수 있다. 이 모델은 2026년 11월 13일 Copilot에 정식 출시됐고, 대상은 Pro, Pro+, Max, Business, Enterprise 사용자다. 모델 선택기에서 고를 수 있는 곳은 VS Code, Visual Studio, JetBrains IDE, Xcode, Eclipse, Copilot CLI, Copilot 코딩 에이전트, GitHub Copilot 앱, github.com, GitHub Mobile, Copilot SDK다 [6]. 요금은 사용량 기반 과금에서 모델 제공사의 정가를 따르고, 출시는 사용자마다 순차적으로 이뤄진다.
개발자 밖으로 넓혀 보면, 구글은 이 모델을 쓸 수 있는 곳으로 Gemini for business, 자격을 갖춘 비즈니스 구독의 구글 시트 속 Gemini, Gemini 앱, 구글 검색을 꼽는다 [1]. 에이전트가 이런 제품을 쓰는 사람들과 워크스페이스를 함께 쓴다면, 양쪽 뒤에서 같은 모델이 돌고 있다고 보면 된다.
한계와 남은 질문은?
이 모델은 텍스트만 출력한다. 이미지나 오디오를 만들지 못하고 Live API도 지원하지 않으므로, 음성 에이전트와 이미지 파이프라인에는 다른 모델이 필요하다 [4]. 비용을 올릴 가능성이 가장 큰 변경은 명시적 캐싱이 사라진 점이다. caches.create로 큰 공통 접두부를 고정해 두던 에이전트는 이제 암시적 캐시 적중에 기대야 하기 때문이다 [3].
벤치마크와 안전 수치는 구글과 파트너가 낸 것이고, 출시 글은 주장마다 전체 평가 내용을 링크하지 않는다 [1]. 가이드는 이 모델을 3.8 Flash와 더 이전의 Gemini 3, 2.5 모델에서 올라갈 권장 모델로 꼽는다. 하지만 우리가 확인한 출처에는 3.8 Flash의 서비스 종료일이 없다 [3]. 종료일이 공지되기 전까지는 2027년 1월 1일 가격 변경이 실질적인 마감일이다.
자주 묻는 질문
Gemini 4 Hydrogen의 모델 ID는 무엇인가?
모델 ID는 gemini-4-hydrogen이다. 안정판 모델이며, Gemini API의 무료와 유료 등급에서 GenerateContent와 Interactions API로 쓸 수 있다.
Gemini 4 Hydrogen의 가격은 얼마인가?
표준 유료 등급에서 100만 토큰당 입력 $1.50, 출력 $7.50이고, 사고 토큰은 출력으로 과금한다. 캐시된 입력은 100만 토큰당 $0.075이며, 일괄 처리(Batch)와 Flex는 가격을 절반인 $0.75와 $3.75로 낮춘다.
Gemini 4 Hydrogen은 명시적 컨텍스트 캐싱을 지원하나?
지원하지 않는다. 이 모델은 암시적 캐싱만 지원하므로, 3.8 Flash에서 옮길 때 cached_content 필드와 caches.create 호출을 지워야 한다.
Gemini 4 Hydrogen은 어떤 사고 수준을 지원하나?
low, medium, high, xhigh 네 가지를 지원하고 기본값은 high다. minimal 수준은 오류로 거부된다. xhigh는 지연 시간과 토큰을 늘리므로, 구글은 어려운 다단계 문제에만 쓰라고 권한다.
GitHub Copilot에서도 Gemini 4 Hydrogen을 쓸 수 있나?
쓸 수 있다. 2026년 11월 13일 Copilot에 정식 출시됐고, 대상은 Pro, Pro+, Max, Business, Enterprise 사용자다. 사용량 기반 과금에서 모델 제공사 정가로 과금한다.