Claude Managed Agents 셀프 호스팅, 내 서버에서 무엇을 직접 운영해야 하나?
2026년 11월 12일 출시된 셀프 호스팅 Claude Managed Agents는 에이전트 루프와 세션, 샌드박스를 자체 인프라에서 돌린다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- Anthropic은 2026년 11월 12일, 에이전트 실행 환경 전체를 자체 인프라에 두는 셀프 호스팅 Managed Agents를 출시했다.
- 사용자는 cma-server, PostgreSQL 16 이상 데이터베이스, 에이전트의 툴을 실행하는 워커를 직접 운영한다.
- 모델 호출은 기본적으로 Claude API로 가며, Bedrock · Google Cloud · Foundry나 직접 운영하는 게이트웨이로 보낼 수도 있다.
- 셀프 호스팅에서는 웹훅, 예약 배포, Files API, 동적 워크플로를 쓸 수 없다.
이 글의 차례
셀프 호스팅 Claude Managed Agents는 Anthropic이 2026년 11월 12일 출시한 기능으로, Managed Agents 서비스 전체를 자체 클라우드 계정이나 데이터 센터에서 돌린다. API, 에이전트 루프, 에이전트와 세션 · 세션 기록을 담는 데이터베이스, 툴을 실행하는 샌드박스를 모두 직접 호스팅한다. 모델 호출은 기본적으로 Claude API로 가며 다른 공급자를 고를 수도 있다. 접근 권한은 Anthropic 계정 팀에 요청한다 [1].
셀프 호스팅 Claude Managed Agents란 무엇인가?
Managed Agents를 운영하는 세 번째 방식이며, Anthropic이 모델 말고는 아무것도 호스팅하지 않는 첫 방식이다. 문서는 Managed Agents에서 직접 호스팅할 수 있는 부분을 둘로 나눈다. 하나는 에이전트의 툴이 명령을 실행하고 파일을 고치는 샌드박스이고, 다른 하나는 API와 에이전트 루프, 에이전트 · 세션 · 세션 기록 저장소로 이뤄진 서비스다 [2]. 셀프 호스팅 샌드박스가 나오면서 첫째 부분은 이미 사용자 쪽으로 넘어왔다. 이번 출시로 둘째 부분까지 넘어온다.
| 방식 | 샌드박스 | 서비스 | 모델 |
|---|---|---|---|
| 클라우드 샌드박스(기본값) | Anthropic | Anthropic | Anthropic |
| 셀프 호스팅 샌드박스 | 사용자 | Anthropic | Anthropic |
| 셀프 호스팅 Managed Agents | 사용자 | 사용자 | Anthropic 또는 직접 고른 공급자 |
직접 운영하는 서버는 호스팅 서비스와 같은 API를 노출한다. 그래서 Claude SDK와 ant CLI를 그대로 쓸 수 있고, 문서에 정리된 차이점을 빼면 나머지 Managed Agents 문서도 똑같이 적용된다 [2]. 클라이언트 코드에서 바뀌는 곳은 두 군데다. 기본 URL(base URL)이 내 서버 주소로 바뀌고, API 키 자리에는 Claude API 키 대신 서버 API 키가 들어간다 [6].
Anthropic은 이 방식을 고를 이유로 두 가지를 든다. 에이전트와 세션, 세션 기록을 반드시 자체 인프라에 저장해야 하는 경우, 그리고 모델 호출을 Amazon Bedrock, Claude Models on Google Cloud(Google 관리형), Microsoft Foundry, 자체 모델 게이트웨이 가운데 한 곳으로 보내야 하는 경우다. 툴만 자체 인프라에서 돌리면 충분하다면 문서는 셀프 호스팅 샌드박스를 쓰라고 안내한다 [2].
셀프 호스팅 배포는 어떻게 동작하나?
배포 하나는 서버 한 대 이상과 서버가 쓰는 데이터베이스, 샌드박스로 이뤄지고, 모두 내 네트워크 안에 있다. 서버는 모델 호출을 하나하나 설정해 둔 추론 공급자(inference provider)로 내보낸다 [2].
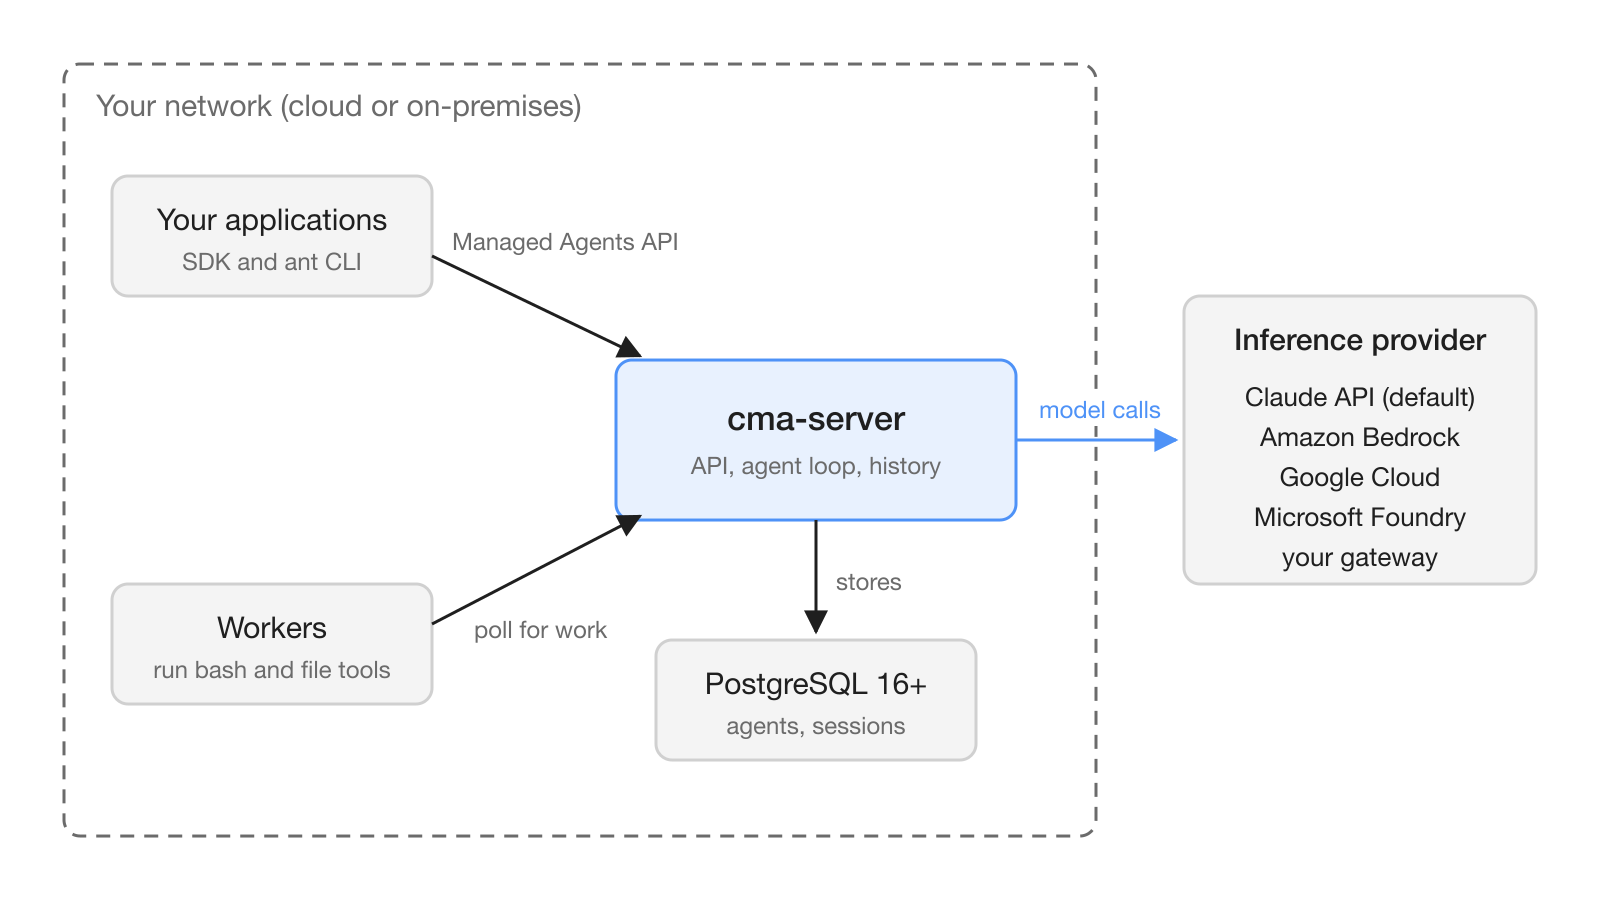
구성 요소는 다음과 같다.
- **
cma-server**는 API를 서비스하고 에이전트 루프를 돌리며, 에이전트와 세션, 기록을 저장하고 추론 공급자를 호출한다. 에이전트의 셸 툴이나 파일 툴은 절대 실행하지 않는다 [2]. - 데이터베이스는 PostgreSQL 16 이상이다. 데이터베이스가 없으면 서버는 데이터를 메모리에 두고, 재시작하면 데이터가 모두 사라진다.
- 워커는 서버에서 작업을 받아 샌드박스 안에서 에이전트의 셸 툴과 파일 툴을 실행한다. 워커는
ant beta:worker명령이나 SDK 워커로 돌린다. - 서버의 콘솔에서는 사람들이 회사의 ID 공급자로 로그인해 에이전트를 만들고 세션을 실행한다.
- **
cma-server-admin**은 관리용 CLI로, 환경(environment)과 환경 키를 만든다. Linux(x86-64, Arm)와 Apple 실리콘 macOS에서 돌아간다.
전체를 묶는 자격 증명은 3가지다. 애플리케이션이 보내는 서버 API 키, 서버만 모델 호출에 쓰는 추론 자격 증명, 워커가 한 환경의 큐를 폴링할 때 쓰는 환경 키다 [2]. 환경과 환경 키는 Claude Console이 아니라 관리용 CLI로 만들고, 환경 키는 365일이 지나면 더는 쓸 수 없다 [6].
모델 호출은 어디로 가나?
서버의 inference.provider 설정이 정한다. 넣을 수 있는 값은 anthropic(기본값, Claude API), bedrock, Claude Models on Google Cloud(Google 관리형)를 뜻하는 vertex, foundry, 직접 운영하는 모델 게이트웨이를 뜻하는 gateway다 [4]. 에이전트는 계속 claude-opus-5-5 같은 Claude API ID로 모델을 지정하고, 서버가 공급자에 맞게 ID를 바꾼다. Bedrock 설정은 다음과 같다.
inference:
  provider: bedrock
  region: us-east-1
게이트웨이는 Claude Messages 형식, Amazon Bedrock의 InvokeModel 형식, Claude Models on Google Cloud의 rawPredict 형식으로 요청을 받을 수 있고, OAuth 교환으로 수명이 짧은 토큰을 받아 쓸 수도 있다 [4]. 설정을 바꾼 뒤 서버 로그에 upstream credential resolved 줄이 찍히면 자격 증명은 제대로 잡혔다. 다만 이 줄만 보고 계정에서 해당 모델이 켜져 있다고 판단하면 안 된다.
일부 기능은 공급자에 따라 쓸 수 있는지가 갈린다. web_search 툴은 anthropic, vertex, foundry에서 동작하고, web_fetch는 anthropic과 foundry에서 동작하며, inference_geo는 anthropic에서만 쓸 수 있다 [3]. anthropic을 쓰면 서버는 기본으로 서버 측 대체 모델(fallback)도 요청한다. 안전 분류기가 요청을 거절하면 다른 Claude 모델이 대신 답할 수 있다는 뜻이다. 이 동작은 inference.model_fallback: false로 끈다.
어떤 데이터가 네트워크 밖으로 나가나?
서버는 직접 설정한 목적지에만 연결한다. 추론 공급자, 서버의 데이터베이스, 허용한 MCP 서버와 Git 호스트, 그리고 OpenTelemetry 수집기나 싱글 사인온(SSO), 시크릿 관리자 같은 선택 서비스다 [5]. 모델 호출에는 지금까지의 대화가 통째로 실리고, 여기에는 프롬프트와 툴 입력, 툴 결과도 들어간다. 서버가 Anthropic에 연결하는 경우는 Claude API가 추론 공급자일 때뿐이며, Anthropic은 서버나 서버 로그에 원격으로 접근할 수 없다.
보안 검토에서 챙길 점이 두 가지 있다. 첫째, Claude API가 모델을 서비스할 때는 호출마다 세션과 에이전트, 환경의 ID를 담은 헤더가 최대 3개 붙고, 이 헤더를 끄는 설정은 없다. 다른 공급자를 쓰면 서버는 이 헤더를 보내지 않는다. 둘째, Claude API와 Microsoft Foundry, Messages 형식 게이트웨이로 가는 호출에는 metadata.user_id에 cma-server라는 라벨이 붙을 수 있다. 이 라벨은 모든 서버에서 똑같다 [5].
데이터 보존도 같은 기준으로 나뉜다. 세션은 직접 지우기 전까지 데이터베이스에 남고, 서버는 오래됐다는 이유로 아무것도 지우지 않는다. 데이터 보존 문서는 호스팅 Managed Agents를 제로 데이터 보존(ZDR) 적용 대상에서 뺀다. Anthropic이 대화 기록을 저장하기 때문이다. 자체 서버에서는 기록을 직접 저장하고, ZDR 계약은 다른 Messages API 호출과 마찬가지로 Claude API로 가는 모델 호출에 적용된다 [5].
호스팅 서비스와 비교해 무엇이 빠졌나?
호스팅 서비스의 기능 여러 개를 쓸 수 없고, 옮겨 오는 데이터도 없다. 에이전트, 스킬, 볼트(vault) 자격 증명, 메모리 저장소, 세션 기록은 자체 서버에서 새로 만들어야 한다 [3].
| 호스팅 기능 | 자체 서버에서는 | 대안 |
|---|---|---|
| 클라우드 환경 | 400 오류를 돌려준다 | 셀프 호스팅 워커를 돌린다 |
| Messages API와 Models API | 404를 돌려준다 | Claude API나 공급자를 직접 호출한다 |
Files API와 file 리소스 | 쓸 수 없다 | 워커의 작업 디렉터리를 쓰거나 메시지에 base64로 담는다 |
mcp_oauth 볼트 자격 증명 | 거부된다 | static_bearer 토큰을 저장하고 직접 교체한다 |
미리 만들어진 docx, pdf, pptx, xlsx 스킬 | 거부된다 | 소스를 커스텀 스킬로 올린다 |
| 예약 배포 | 라우트가 없다 | cron 같은 자체 스케줄러로 예약 세션을 시작한다 |
| Dreams | 라우트가 없다 | 대안이 없다 |
| 웹훅 | 보내지 않는다 | 이벤트 스트림을 따라가고 워커는 계속 폴링한다 |
멀티에이전트 오케스트레이션도 범위가 좁다. 서버는 하위 에이전트(subagent)를 1~20개 나열한 coordinator 블록만 받는다. 동적 워크플로, 어드바이저(advisor), 에이전트가 스스로 정의한 하위 에이전트는 쓸 수 없고, 호스팅 예제에 나오는 multiagent_20261001 타입은 400 오류를 돌려준다 [3].
어떤 기능은 먼저 설정해야 쓸 수 있다. 서버는 mcp.allowed_hostnames에 적힌 MCP 호스트에만 연결한다. 이 목록은 이름이 정확히 같아야 맞는 것으로 보고, 처음에는 비어 있다. 대신 사설 네트워크 안의 MCP 서버라면 MCP 터널이 필요 없다. Git 호스트는 git.allowed_hostnames에 등록해야 하고, 푸시는 git.allowed_push_refs에 적힌 곳으로만 할 수 있으며, Git 토큰은 샌드박스까지 가지 않는다. web_search와 web_fetch 툴은 web_tools.enabled: true로 설정하기 전까지 꺼져 있다 [3].
mcp:
  allowed_hostnames:
    - mcp.example.com
git:
  allowed_hostnames:
    - github.com
  allowed_push_refs:
    - refs/heads/agent/
web_tools:
  enabled: true
AI 에이전트를 운영하는 팀에는 무엇이 달라지나?
가장 큰 변화는 에이전트 루프와 세션 기록 보관소를 코드와 내부 시스템 바로 옆, 자체 보안팀이 관리하는 데이터베이스에 둘 수 있다는 점이다. 대가는 운영 부담이다. 서버와 데이터베이스, 샌드박스를 직접 운영하고 보호해야 하며, 새 릴리스도 직접 설치해야 한다 [2].
격리의 단위도 환경이 아니라 배포다. 배포 하나는 신뢰 수준이 하나인 테넌트 하나만 맡는다. 서버 API 키로는 모든 환경에 접근할 수 있고, 환경 키로는 해당 환경에 있는 모든 세션의 이벤트를 읽을 수 있다 [5]. 신뢰하는 작업과 신뢰하지 않는 작업이 한 서버를 함께 쓴다면 각각 별도 배포로 나누고, 데이터베이스와 서버 API 키, 워커도 따로 둬야 한다. Hardi AI처럼 공유 워크스페이스 하나에서 여러 그룹의 에이전트를 운영하는 팀이라면 신뢰 경계마다 배포를 하나씩 두게 된다.
어떻게 써 볼 수 있나?
먼저 머신 한 대에서 Docker Compose 퀵스타트로 시작하고, 운영 환경은 Helm 차트로 옮긴다 [7]. Compose 스택은 서버와 PostgreSQL 데이터베이스, 그리고 세션마다 샌드박스 컨테이너를 띄우는 워커 여러 개를 실행한다. 일반 HTTP로만 서비스하므로 개발용으로만 써야 한다.
- Anthropic 계정 팀에서 릴리스 아카이브를 받고, CPU 2개 이상, Compose 플러그인을 설치한 Docker Engine,
openssl,antCLI를 갖춘 호스트를 준비한다. - 퀵스타트 문서에 나온 대로
.env파일을 만들고, Claude API 키와 새로 생성한 서버 API 키, 나머지 생성한 시크릿 값을 넣는다. docker compose up --build -d를 실행하고,/cma-server/readyz가 준비 완료 상태로 응답할 때까지 기다린다.- 두 번째 터미널을 열어 환경 변수
ANTHROPIC_BASE_URL에는 서버 주소를,ANTHROPIC_API_KEY에는 서버 API 키를 넣은 뒤antCLI로 에이전트와 세션을 만든다. - 에이전트에게
hostname을 실행하게 한다. 이름이cma-sandbox-로 시작하면 툴이 샌드박스 컨테이너 안에서 실행됐다는 뜻이다 [7].
docker compose는 첫 번째 터미널에서 계속 실행한다. Compose가 내 서버를 가리키는 ANTHROPIC_BASE_URL을 물려받으면 서버가 Claude API 대신 자기 자신을 호출하게 된다.
한계와 남은 질문은?
릴리스 노트에는 셀프 호스팅의 가격도, 정식 출시 날짜도 나와 있지 않고, 접근 권한은 계정 팀으로만 받을 수 있다 [1]. Compose 스택에는 실제로 부딪힐 한계가 2가지 있다. 워커는 10개가 뜨는데, 워커 하나가 한 번에 세션 하나만 맡는다. 또 샌드박스 컨테이너는 시작하고 1시간쯤 지나면 종료되고, 진행 중이던 턴은 /workspace가 빈 새 컨테이너에서 이어진다 [7][6]. 그래서 긴 턴은 작업 결과를 중간중간 푸시해 둬야 한다. 마지막으로 MCP 툴 결과가 mcp.max_result_bytes(기본값 100 KiB)를 넘으면 잘리고, 잘린 부분은 사라진다 [3].
자주 묻는 질문
셀프 호스팅 샌드박스와 셀프 호스팅 Claude Managed Agents는 무엇이 다른가?
셀프 호스팅 샌드박스에서는 에이전트의 툴이 실행되는 컨테이너만 직접 운영하고, API와 에이전트 루프, 세션 저장소는 Anthropic이 운영한다. 셀프 호스팅 Claude Managed Agents에서는 샌드박스와 이 서비스를 모두 직접 운영하며, 모델은 Anthropic이나 직접 고른 공급자에서 돌아간다.
셀프 호스팅 서버는 Anthropic으로 데이터를 보내나?
Claude API가 추론 공급자일 때만 보낸다. 이때 모델 호출마다 지금까지의 대화와 세션 · 에이전트 · 환경 ID를 담은 헤더가 실린다. Anthropic은 서버나 서버 로그에 원격으로 접근할 수 없다.
셀프 호스팅 서버에서 모델 호출을 Bedrock이나 Foundry로 보낼 수 있나?
보낼 수 있다. 서버의 inference.provider 설정에는 기본값인 anthropic(Claude API), bedrock, Google이 관리하는 Google Cloud의 Claude 모델을 뜻하는 vertex, foundry, 직접 운영하는 모델 게이트웨이를 뜻하는 gateway 가운데 하나를 넣는다. 에이전트는 계속 Claude API 모델 ID를 그대로 쓰고, 서버가 이 ID를 각 공급자에 맞게 바꿔 준다.
호스팅 Managed Agents 데이터를 셀프 호스팅 서버로 옮길 수 있나?
옮길 수 없다. 세션 기록을 포함해 호스팅 서비스의 데이터는 하나도 복사되지 않으므로, 에이전트와 스킬, 볼트 자격 증명, 메모리 저장소를 자체 서버에서 새로 만들어야 한다.
셀프 호스팅 서버에서도 웹훅과 예약 배포가 동작하나?
동작하지 않는다. 셀프 호스팅 서버는 웹훅을 보내지 않고 예약 배포용 라우트도 없다. 세션은 이벤트 스트림으로 따라가고, 예약 세션은 cron 같은 자체 스케줄러로 시작한다.