GPT-6.2 Astra·Sol 출시, 에이전트 개발자는 무엇을 바꿔야 하나?
2026년 11월 17일 나온 GPT-6.2 Astra와 Sol은 대화 기록을 고치면 추론 항목을 버리고, 지시문을 입력 뒤에 두며, 2시간·8시간 할인 창을 더했다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- 2026년 11월 17일 두 모델 gpt-6.2-astra(입력·출력 100만 토큰당 $8/$40)와 gpt-6.2-sol($2/$10)이 API로 출시됐다.
- 이제 대화 기록을 고치거나, 일부 모델을 바꾸거나, 사용자나 조직이 바뀌면 추론 항목이 사라진다.
- 최상위 instructions는 input 뒤에 붙고 캐시 없는 요금으로 청구된다. 바뀌지 않는 지시는 developer 메시지에 둬야 한다.
- 2h·8h 백그라운드 창을 쓰면 모델 토큰 요금이 30%·40% 내려가고, Flex는 지원하지 않는다.
이 글의 차례
GPT-6.2 Astra와 Sol은 OpenAI가 2026년 11월 17일 API에 추가한 두 모델이다. Astra(gpt-6.2-astra)는 어려운 추론과 코딩용이고, Sol(gpt-6.2-sol)은 일상적인 코딩과 에이전트 워크플로용이다 [1]. Responses API로 에이전트 루프를 돌린다면 모델을 바꾸기 전에 네 가지를 확인해야 한다. 기록을 고치면 추론 항목이 사라지고, 최상위 instructions가 input 뒤로 가며, 샘플링 파라미터가 빠졌고, Flex 처리를 쓸 수 없다 [2].
GPT-6.2 Astra와 Sol은 어떤 모델인가?
두 모델은 한도가 같고 가격만 다르다. 둘 다 컨텍스트 창이 1,050,000 토큰이고, 입력은 최대 922,000 토큰, 출력은 최대 128,000 토큰까지다. 입력으로 텍스트와 이미지를 받고, 출력은 텍스트만 낸다 [3][4]. OpenAI는 Astra를 "가장 어려운 프로젝트를 위한 가장 뛰어난 모델"로, Sol을 "코딩부터 대규모 에이전트 운영까지 일상 업무에 기본으로 쓰는 모델"로 소개한다 [3][4].
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| 모델 ID | gpt-6.2-astra | gpt-6.2-sol |
| 입력(100만 토큰당) | $8 | $2 |
| 캐시된 입력(100만 토큰당) | $0.40 | $0.10 |
| 출력(100만 토큰당) | $40 | $10 |
| 캐시 쓰기(30분 TTL) | $10 | $2.50 |
| 지식 기준일 | 2026년 5월 18일 | 2026년 6월 1일 |
| 컨텍스트 창 | 1,050,000 토큰 | 1,050,000 토큰 |
가격은 모델 페이지에 나온 Standard 요금이다 [3][4]. 프롬프트가 길면 더 비싸다. 입력 토큰이 272K를 넘으면 입력 요금과 캐시 요금이 2배가 되고, 출력은 짧은 컨텍스트 요금의 1.5배가 된다. Batch는 Standard의 50%, Fast 모드는 Standard의 2배다. Ultrafast는 2027년 2월 28일까지 Standard의 3배이고, 2027년 3월 1일부터는 6배다 [3].
두 모델 모두 Chat Completions, Responses, Batch에서 쓸 수 있다. Realtime, Assistants, 파인튜닝은 둘 다 지원하지 않는다. Responses API에서는 웹 검색, 파일 검색, 코드 인터프리터, 호스티드 셸, apply patch, 스킬, 컴퓨터 사용, MCP, 툴 검색을 쓸 수 있다 [3]. 툴 호출은 Responses API에서만 된다 [1]. 따라서 Chat Completions로 툴을 부르는 에이전트는 먼저 Responses로 옮겨야 한다.
GPT-6.2에서 Responses API는 무엇이 달라지나?
GPT-6.2는 긴 에이전트 대화에 영향을 주는 동작 두 가지를 바꿨다. 첫째는 추론 항목(reasoning item)이다. GPT-6.2부터 Responses API는 세 가지 경우에 추론 항목을 버린다. 대화 도중 앞선 기록을 고칠 때(프리픽스 수정), 다운그레이드를 포함한 일부 모델 변경이 있을 때, 최종 사용자나 조직이 바뀔 때다 [2]. 가이드는 추론 항목이 없으면 답의 품질이 떨어질 수 있고, 모델이 앞서 한 작업을 다시 하느라 토큰을 더 쓸 수 있다고 경고한다.
기록을 다시 쓰는 에이전트 루프라면 이 규칙을 꼭 챙겨야 한다. 앞선 툴 호출을 고치거나, 앞선 developer 메시지의 문구를 바꾸거나, 작업 도중 모델을 다운그레이드하면 어느 쪽이든 추론 항목이 사라질 수 있다. OpenAI는 응답 사이에 설정을 바꾸더라도 프리픽스는 손대지 말라고 권한다. 그래야 앞선 입력도 프롬프트 캐싱 대상으로 남는다 [2].
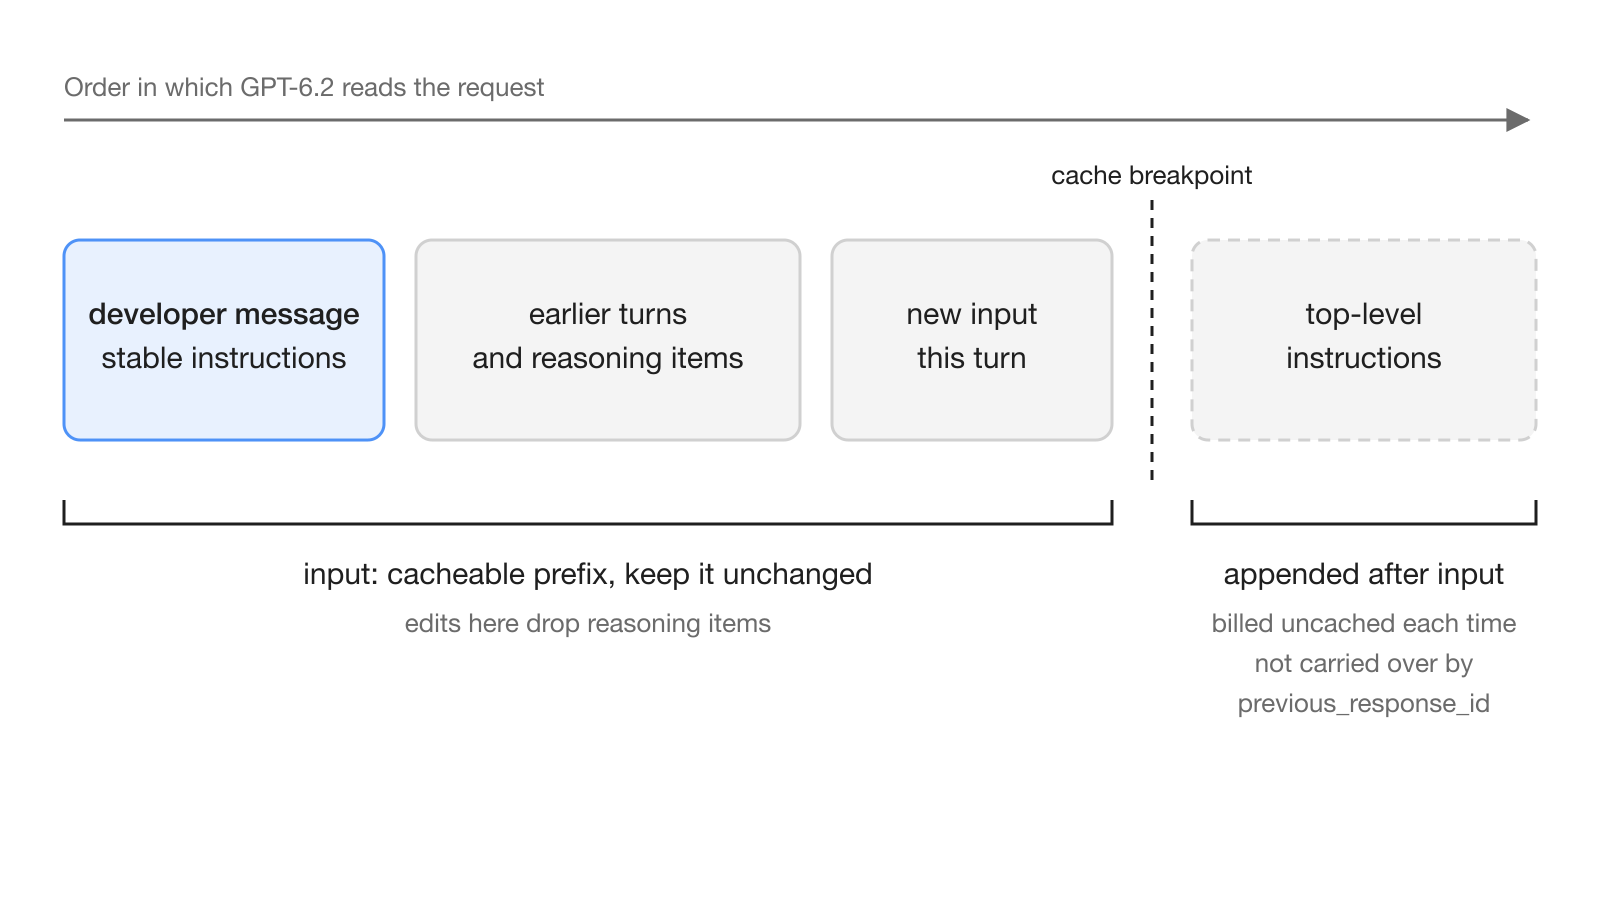
둘째는 지시문의 위치다. GPT-6.2 이후 모델은 최상위 instructions 필드를 input 뒤에 붙인다 [2]. 프롬프트 캐싱 가이드는 이 변화가 비용에 미치는 영향을 분명히 적어 두었다. 이 지시문은 캐시 경계(cache breakpoint) 뒤에 놓이므로, 같은 내용이 반복되더라도 요청마다 캐시 없는 요금으로 청구된다. previous_response_id로 다음 응답에 이어지지도 않는다. 반면 input 맨 앞에 둔 developer 메시지는 대화 기록에 남고 캐시될 수 있다 [6].
에이전트를 GPT-6.2로 옮기면 무엇이 깨지나?
마이그레이션 가이드에는 예전 모델에서 쓰던 요청을 그대로 옮기면 오류를 내는 파라미터 변경이 정리돼 있다 [2].
| 영역 | 바꿀 점 |
|---|---|
| 샘플링(Chat Completions) | temperature, top_p, logprobs, top_logprobs를 뺀다 |
| 샘플링(Responses) | temperature, top_p, top_logprobs를 빼고, include에서 message.output_text.logprobs를 지운다 |
| 추론 강도 | 새 연결은 medium에서 시작하고, none이나 minimal은 low로 바꾼다 |
| 툴 호출 | Responses API를 쓴다 |
| 처리 등급 | service_tier: flex는 지원하지 않는다 |
| 캐시 수명 | GPT-5.5 이하에서 옮겨 온다면 prompt_cache_retention 대신 prompt_cache_options.ttl을 쓰고 값을 "30m"으로 정한다 |
| Zero Data Retention | store는 false로 처리된다. 이전 출력 항목은 암호화된 추론 항목까지 포함해 순서대로 다시 넘긴다 |
두 모델 페이지 모두 API가 추론 강도 none을 거부한다고 적고 있다 [3][4]. 데이터 레지던시도 처리 등급마다 다르다. 두 모델은 Standard, Fast, Batch 처리에서 미국과 EU 레지던시를 지원하지만, Ultrafast는 미국에서만 쓸 수 있다 [2].
출력 스타일도 바뀐다. 가이드에 따르면 GPT-6.2 Astra는 기본적으로 이전 모델보다 간결하고 직설적이다. 따라서 "간결하게 답하라" 같은 지시는 다시 검토하는 편이 좋다. 또 이 모델은 다음 단계를 제안한 뒤 확인을 기다릴 수 있다. 에이전트가 스스로 계속 진행해야 한다면 프롬프트에 분명히 적어야 한다. 범위 안에서는 계속 진행하고, 막힌 일이나 사용자가 내려야 할 결정, 되돌릴 수 없는 작업 앞에서만 멈추라고 쓰면 된다 [2].
캐시 요금 계산도 다르다. GPT-5.6 이후 모델에서 캐시 쓰기 요금은 30분 TTL이면 캐시 없는 입력 요금의 1.25배, 12시간 TTL이면 2.5배이고, 이 배수가 전체 요금이다. GPT-6.2 Astra와 Sol에서 캐시 읽기는 입력 요금의 0.05배다. 프리픽스가 캐시되려면 눈에 보이는 입력 토큰이 최소 1,024개 있어야 한다 [6].
새 백그라운드 완료 창은 어떻게 동작하나?
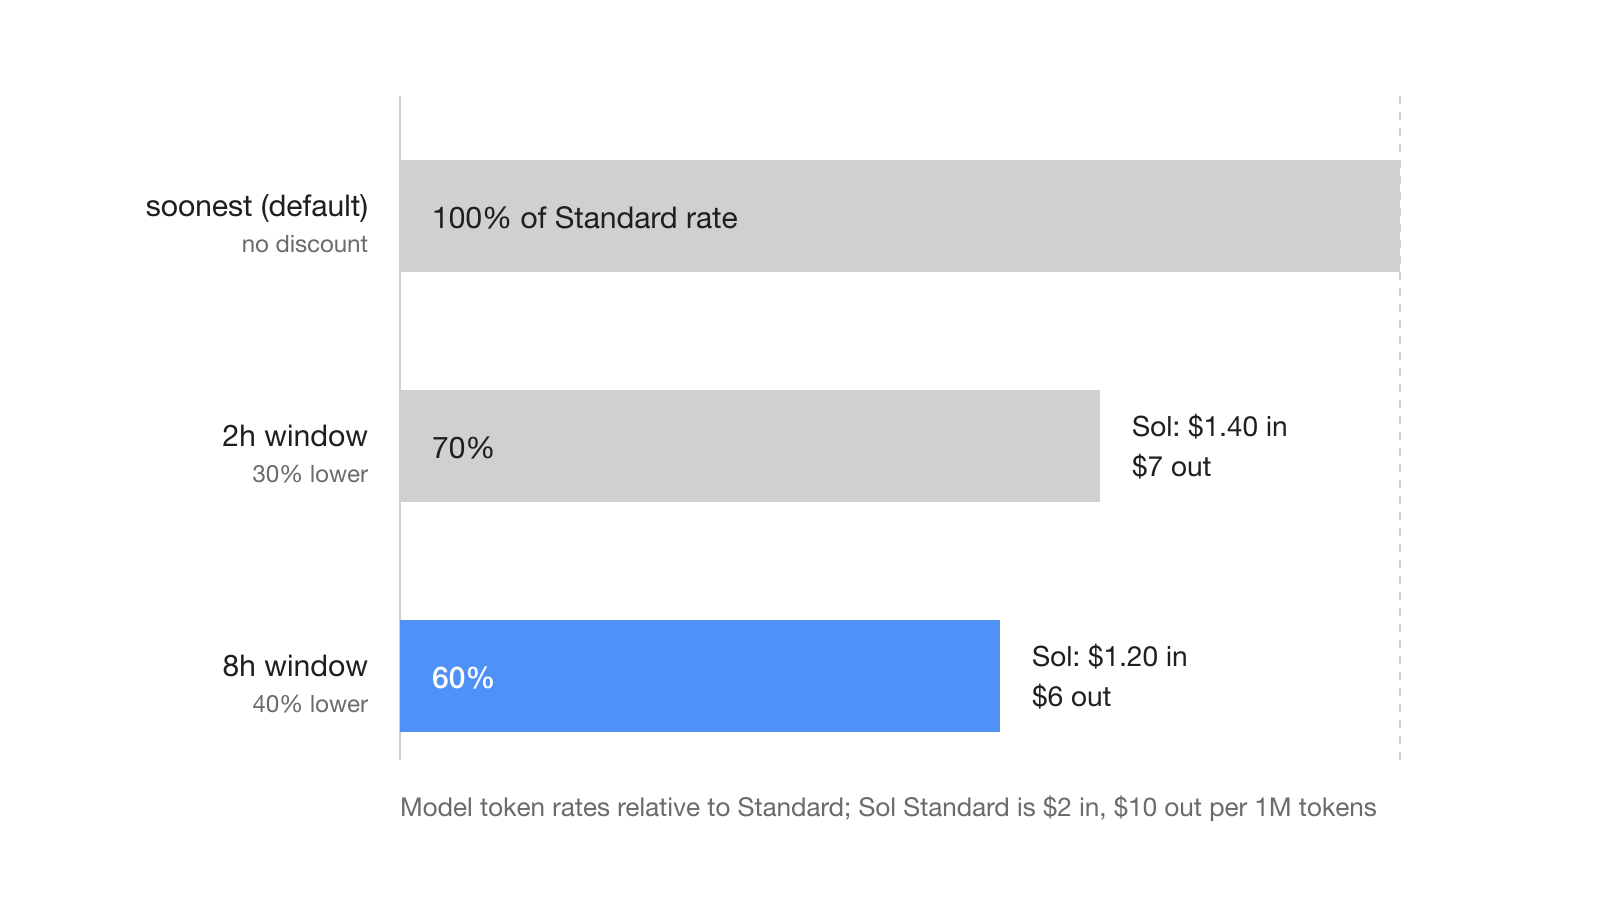
백그라운드 완료 창(background completion window)은 공개 베타 기능으로, 역시 2026년 11월 17일에 나왔다. Responses 요청을 가능한 한 빨리 끝내는 대신 2시간이나 8시간 안에 끝내도 된다고 허용하면, 모델 토큰 요금이 Standard보다 30% 또는 40% 낮아진다. gpt-6.2-astra, gpt-6.2-sol, gpt-6.1-terra, gpt-6-luna에서 쓸 수 있다 [1]. 마이그레이션 가이드는 GPT-6.2에서 Flex 처리 대신 쓸 방법으로 이 기능을 소개한다 [2].
쓰는 방법은 간단하다. background를 true로 두고, 스트리밍은 끄고, service_tier를 default로, background_options.completion_window를 2h나 8h로 정한다. 기본 창은 soonest이고 할인이 없다. service_tier: auto로 보내면 API가 Standard 처리를 고른 경우에만 할인을 받는다 [5].
밤사이 돌리는 에이전트 작업이라면 요청 본문은 다음과 같다.
{
  "model": "gpt-6.2-sol",
  "background": true,
  "service_tier": "default",
  "background_options": { "completion_window": "8h" },
  "reasoning": { "effort": "medium" },
  "prompt_cache_options": { "ttl": "30m" },
  "input": [
    { "role": "developer", "content": "You triage the open support tickets and draft replies." },
    { "role": "user", "content": "Process today's queue." }
  ]
}
가이드는 API가 "요청을 수락한 뒤 선택한 창 안에 완료를 목표로 한다"고 밝히고, 재시도할 수 있는 용량 오류는 자동으로 다시 시도한다고 설명한다 [5]. 창을 넘긴 응답이 어떻게 되는지는 가이드에 나와 있지 않다. 결과는 response.completed 같은 웹훅을 구독해 받거나, 상태가 queued나 in_progress인 동안 ID로 응답을 폴링해 가져온다. 취소하려면 POST /v1/responses/{id}/cancel을 보낸다.
계획을 세울 때 염두에 둘 규칙은 세 가지다 [5].
2h와8h창 요청은 Batch API 작업과 Batch/Background 레이트 리밋을 함께 쓰고, 입력 토큰은 제출하는 시점에 이 한도에서 차감된다.- 할인 창 밖의 Standard 요청은
2h나8h요청이 만든 캐시 항목을 다시 쓸 수 없다. 프롬프트가 똑같아도 마찬가지다. - 스트리밍은
soonest에서만 된다. 백그라운드 모드는store가false이거나 Zero Data Retention이 켜져 있어도 응답 데이터를 잠시 저장한다.
공개된 요금대로 계산하면 8시간 창에서 GPT-6.2 Sol은 100만 토큰당 입력 $1.20, 출력 $6이 되고, GPT-6.2 Astra는 입력 $4.80, 출력 $24가 된다 [1][3][4].
AI 에이전트를 운영하는 팀에는 무엇이 달라지나?
팀이 모델을 고를 때 기준은 모델 이름보다 작업의 성격이다. Sol은 입력과 출력 모두 Astra 가격의 4분의 1이면서 컨텍스트 창과 툴은 같다 [3][4]. 일상적인 에이전트 작업이라면 Sol을 기본값으로 쓰는 편이 자연스럽다. Astra는 Sol로 해내지 못하는 작업에 남겨 둔다. 야간 보고서, 백로그 분류, 리서치 요약처럼 아무도 결과를 기다리지 않는 작업은 8시간 창에 맞는다. 채팅 채널에서 사람과 대화하는 에이전트는 soonest를 그대로 쓴다.
추론 항목 규칙은 팀이 공유 에이전트를 운영하는 방식에도 영향을 준다. 스레드를 한 조직에서 다른 조직으로 넘기면 추론 항목이 사라진다. 대화 도중 Astra에서 Sol로 바꾸는 일도 추론 항목을 버리는 모델 변경에 해당할 수 있다. 가이드는 다운그레이드를 예로 들지만 어떤 전환이 해당하는지는 나열하지 않는다 [2]. 모델은 작업 도중에 바꾸기보다 작업을 시작할 때 정해 두는 편이 안전하다.
한계와 남은 질문은?
문서에는 아직 빠진 내용이 있다. 백그라운드 가이드는 할인 요청이 창을 넘기면 어떻게 되는지 밝히지 않는다 [5]. 모델 페이지에는 날짜가 붙은 스냅샷이 없고 gpt-6.2-astra와 gpt-6.2-sol ID만 있다 [3][4]. 두 모델 모두 파인튜닝과 예측 출력(predicted outputs)을 지원하지 않고, 오디오와 비디오 입력도 받지 않는다. 마이그레이션 가이드는 "다운그레이드를 포함한 일부 모델 변경"이라고만 적었을 뿐, 어떤 모델 변경이 추론 항목을 버리게 하는지 정확히 나열하지 않는다 [2]. 가이드가 이를 밝힐 때까지는 대화 안에서 모델을 바꾸면 추론이 사라질 수 있다고 보고 대비해야 한다.
자주 묻는 질문
GPT-6.2 Astra와 Sol은 성능과 가격이 어떻게 다른가?
Astra는 가장 까다로운 추론과 코딩을 위한 OpenAI 모델로, 100만 토큰당 입력 $8, 출력 $40이다. Sol은 일상적인 코딩과 에이전트 워크플로를 겨냥하며 입력 $2, 출력 $10이다. 두 모델 모두 컨텍스트 창은 1,050,000 토큰이고 Responses API에서 쓰는 툴도 같다.
GPT-6.2에서도 temperature 같은 샘플링 파라미터를 쓸 수 있나?
쓸 수 없다. 두 모델을 호출하는 요청에는 샘플링 파라미터를 넣지 않아야 한다. 마이그레이션 가이드에 따르면 temperature, top_p, top_logprobs를 빼야 하고, Chat Completions로 호출할 때는 logprobs도 함께 빼야 한다.
GPT-6.2는 왜 긴 에이전트 대화에서 추론을 잃나?
GPT-6.2부터 Responses API는 앞선 대화 기록을 고치거나, 다운그레이드를 포함한 일부 모델 변경이 있거나, 최종 사용자나 조직이 바뀌면 추론 항목을 버린다. 프리픽스를 그대로 두면 추론과 프롬프트 캐싱이 모두 유지된다.
백그라운드 완료 창은 OpenAI API 비용을 어떻게 낮추나?
Responses 요청에서 background를 켜고, service_tier는 default로 두고, 완료 창(completion_window)을 2h나 8h로 정하면 된다. 아직 공개 베타 단계이며, 이렇게 보낸 요청은 모델 토큰 요금이 표준 요금보다 2시간 창에서 30%, 8시간 창에서 40% 낮아진다.
GPT-6.2에서 Flex 처리를 쓸 수 있나?
쓸 수 없다. GPT-6.2 Astra와 Sol은 service_tier flex를 지원하지 않는다. 오래 걸리는 Responses 요청이라면 OpenAI가 대안으로 내놓은 할인된 2시간·8시간 백그라운드 완료 창을 쓰면 된다.