Gemini API Tool Retrieval이란? 에이전트가 툴을 필요할 때만 불러오는 법
Gemini API Tool Retrieval은 2026년 11월 19일 프리뷰로 나왔고, 에이전트가 defer_loading으로 툴 스키마를 미뤄 두었다가 필요할 때 불러온다.
영어 원문을 한국어로 옮긴 글이에요.Read in English
핵심 정리
- Gemini API Tool Retrieval은 2026년 11월 19일 프리뷰로 공개됐고, 지금은 Interactions API에서만 쓸 수 있다.
- 지연 로딩한 툴은 모델이 전체 스키마를 불러오기 전까지 이름과 설명만 보인다.
- 서버 측 모드에서는 검색, 스키마 로딩, 함수 호출이 요청 하나 안에서 끝난다.
- 별도 요금은 없지만, 서버 측 검색은 할 때마다 입력 요금으로 과금되는 모델 호출이 하나 더 붙는다.
이 글의 차례
Tool Retrieval은 2026년 11월 19일에 발표된 Gemini Interactions API의 프리뷰 기능이다. 툴이 많은 Gemini 에이전트도 요청마다 모든 파라미터 스키마를 보내지 않아도 된다 [1]. 툴에 defer_loading: true를 표시하고 tool_search 툴을 하나 넣으면, 모델은 지연 로딩한 툴의 이름과 설명만 보다가 실제로 필요한 툴의 전체 스키마만 불러온다 [2].
Gemini API Tool Retrieval은 무엇인가?
Tool Retrieval은 툴이 수십, 수백 개에 이르는 에이전트의 규모 문제에 Google이 내놓은 답이다. Gemini API 프로덕트 매니저 Lucia Loher와 Google DeepMind 연구 과학자 Nora Kassner는 요청마다 모든 툴의 전체 파라미터 스키마가 함께 오가면 생기는 일을 이렇게 설명한다. 입력 토큰이 늘고, 지연 시간이 길어지며, 모델이 알맞은 툴을 잘 고르지 못하게 될 수 있다 [1].
이 기능은 프리뷰 단계이고, v1beta API 버전이 필요하며, generateContent가 아닌 Interactions API에서만 동작한다 [2]. Interactions API 자체는 2026년 6월부터 정식 버전으로 쓸 수 있고, Google이 새 프로젝트에 권하는 인터페이스다 [3].
가이드에 나온 지원 모델은 gemini-4-carbon, gemini-4-neon, gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash다 [2]. 발표문은 범위를 더 넓게 잡아 Gemini 3.6 이후 모델과 모든 Gemini 4 모델이라고 적는다 [1]. 이 밖의 모델에서 툴을 지연 로딩하는 요청을 보내면 "deferred loading is not supported for this model" 오류가 나며 요청이 실패한다 [2].
Tool Retrieval은 어떻게 동작하나?
Tool Retrieval은 툴 하나를 두 부분으로 나눈다. 모델이 늘 보는 가벼운 요약과, 필요할 때만 불러오는 전체 스키마다. 기본값인 서버 측 모드에서는 검색과 스키마 로딩, 함수 호출이 모두 API 요청 하나 안에서 끝난다 [1].
tools배열에{"type": "tool_search"}를 넣고, 미뤄 둘 함수마다defer_loading: true를 설정한다 [2].- 모델은 지연 로딩한 툴마다 이름과 설명은 보지만 파라미터 스키마는 보지 못한다.
- 툴이 필요해지면 모델이 이름으로 해당 툴을 요청한다. API가 스키마를 불러오고, 모델은 평소와 같은 함수 호출을 낸다.
- 응답에는 단계가
tool_search_call,tool_search_result,function_call순서로 담긴다. 애플리케이션은function_call만 실행하면 된다 [2].
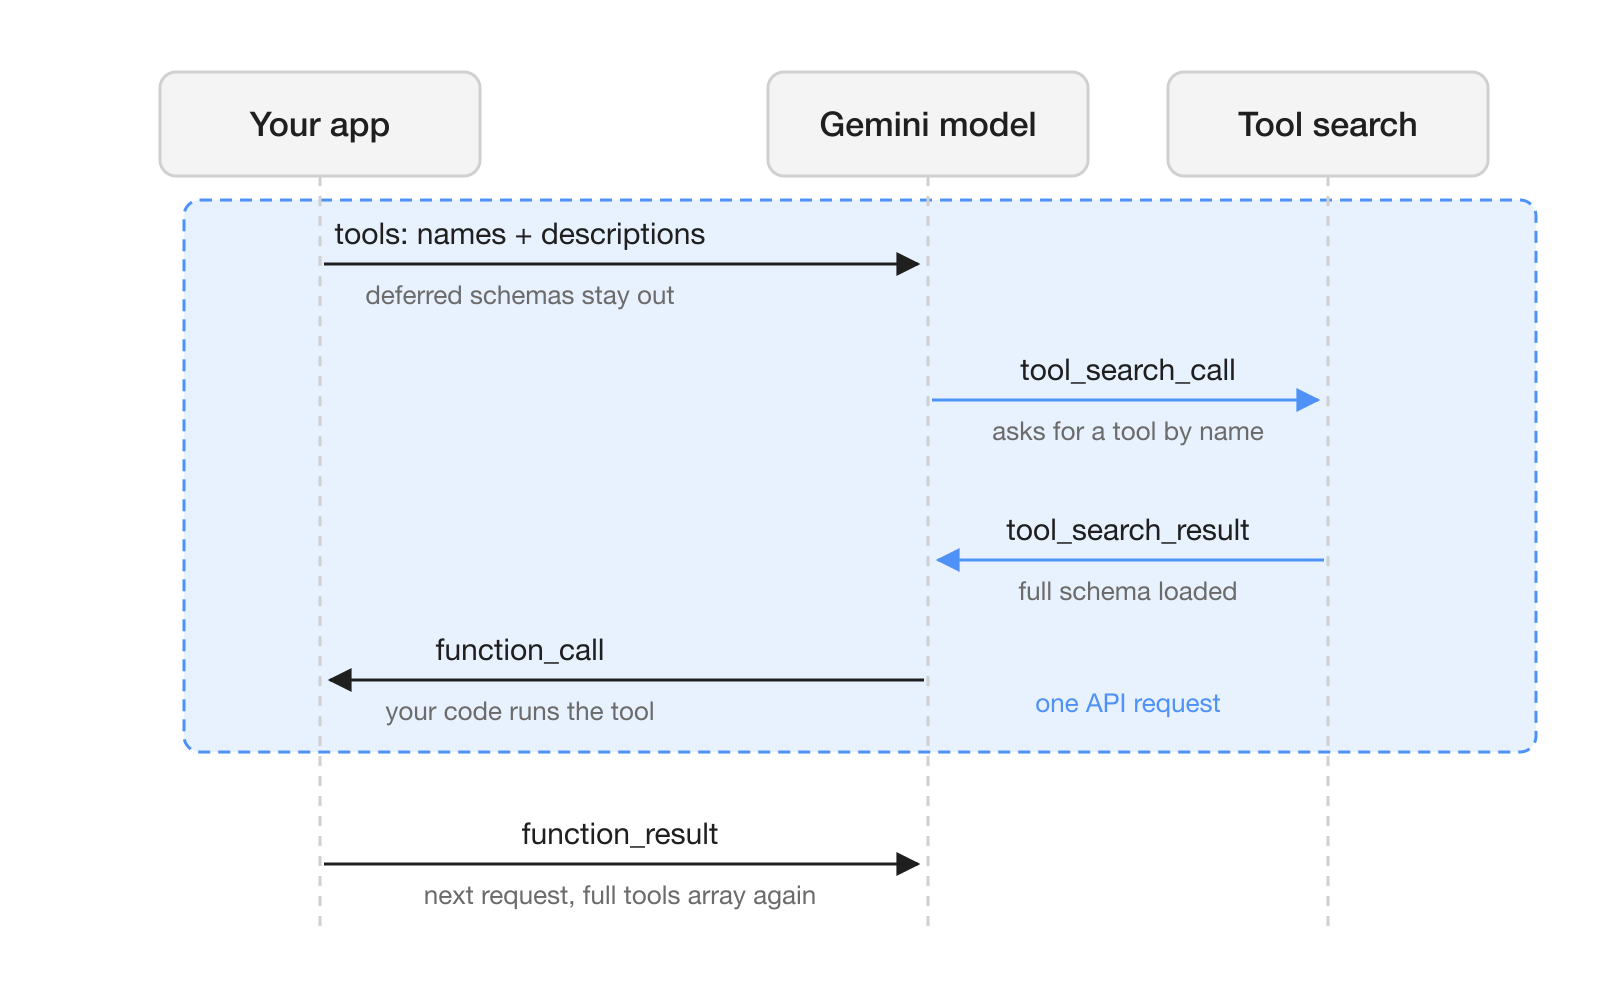
검색은 Gemini가 자체 서버에서 돌리므로 인덱스를 만들거나 호스팅할 필요가 없다 [1]. 검색 단계가 응답에 함수 호출과 나란히 나오기 때문에, 모델이 어떤 툴을 찾아봤는지 확인할 수 있다. 툴 이름이나 설명이 모델을 헷갈리게 할 때 원인을 찾기 쉽다.
Tool Retrieval은 프리픽스 캐싱(prefix caching)과도 잘 맞는다. 지연 로딩한 스키마는 프롬프트 프리픽스에 들어가지 않으므로, 대화가 몇 번 오가도 캐시된 프리픽스가 그대로 유지된다 [1]. 불러온 스키마는 뒤쪽에 인라인으로 붙기 때문에, 프리픽스가 최소 캐시 가능 크기에 이르면 암묵적 캐싱(implicit caching)도 그대로 적용된다 [2].
어떻게 켜나?
기존 Interactions API 요청에서 두 가지만 바꾸면 된다. tool_search 항목을 하나 넣고, 미뤄 둘 툴에 defer_loading 플래그를 붙인다 [2]. 아래 코드는 가이드에 실린 Python 예제의 모양을 따랐고, 함수와 파라미터는 자리 표시용으로 지어낸 값이다.
tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "billing_issue_refund",
        "description": "Billing: refund an order to the original payment method.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"},
            },
            "required": ["order_id", "amount"],
        },
        "defer_loading": True,
    },
    # ... the rest of the long tail, each with "defer_loading": True
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 dollars on order A-1042.",
    tools=tools,
)

for step in interaction.steps:
    if step.type == "function_call":
        ...  # run the function, then send a function_result
가이드의 설정 규칙은 짧다 [2].
| 설정 | 규칙 |
|---|---|
execution | "server"(기본값) 또는 "client" |
tool_search의 name, description | 클라이언트 측 검색에서는 필수(parameters는 선택), 서버 측에서는 넣지 않는다 |
defer_loading | function과 mcp_server 항목에 쓸 수 있고, 서버 측 tool_search가 있어야 한다 |
short_description | 검색할 때 보여 주는 짧은 요약, defer_loading: true일 때만 유효하다 |
tool_search 항목 수 | 요청당 1개 |
가이드가 권하는 습관 세 가지를 지키면 예상 밖의 문제를 대부분 피할 수 있다. 가장 자주 쓰는 툴은 처음부터 불러 두고, 드물게 쓰는 나머지(long tail)만 미룬다. 시스템 지시문이나 툴 출력에서 이름으로 언급하는 툴은 미루지 않는다. 그리고 응답마다 interaction.steps에 function_call이 있는지 확인한다. function_call이 있어도 status가 늘 requires_action으로 오지는 않기 때문이다 [2].
여러 번 주고받는 대화에서는 무엇이 달라지나?
대화가 여러 번 오가면 검색 단계를 개발자가 직접 다음 요청으로 넘겨야 한다. API는 툴 선언을 저장하지 않으므로, function_result를 담은 후속 요청까지 포함해 모든 요청에 tools 배열 전체를 다시 보내야 한다 [2].
store=false로 실행하면서 대화 기록을 직접 관리한다면, 응답 단계를 하나도 고치지 말고 모두 덧붙이고 tool_search_call과 tool_search_result의 순서도 지켜야 한다. 검색 단계에는 암호화된 signature가 붙어 있고, 이 값은 받은 그대로 돌려보내야 한다 [2]. 또 store=false를 쓰면 previous_interaction_id도 쓸 수 없다 [3].
클라이언트 측 검색이나 MCP 지연 로딩은 언제 쓰나?
툴 목록이 고정돼 있지 않으면 클라이언트 측 검색을 쓰고, 원격 서버 하나가 툴을 많이 내놓으면 MCP 지연 로딩을 쓴다. 가이드의 기준은 단순하다. 바뀌지 않는 툴이 20개 미만이면 정적 로딩이 맞다. 크고 목록이 정해진 툴 라이브러리와 MCP 서버에는 서버 측 검색이 맞고, 지연 시간 면에서도 더 낫다. 동적 레지스트리, 네임스페이스, 사용자별 툴에는 클라이언트 측 검색이 맞다 [2].
클라이언트 측 검색을 쓰려면 tool_search를 "execution": "client"로 선언하고, 직접 정한 name과 description을 붙인다. 필요하면 parameters도 넣는데, 예를 들어 query와 선택 항목인 namespace 필터를 둘 수 있다. 모델이 이 툴을 호출하면 애플리케이션이 검색을 실행하고, 완전한 함수 선언을 function_result.result에 담아 돌려준다. 검색할 때마다 왕복이 한 번 늘고, 앞뒤 요청은 previous_interaction_id로 엮는다 [2]. 대신 툴을 미리 선언하지 않아도 되므로, 대화 도중에도 새 툴을 내놓을 수 있다. 사용자가 새 서비스를 연결한 직후가 좋은 예다 [1]. 이미 운영하는 임베딩 인덱스나 사용자별 권한 필터를 붙일 자리도 이 모드다.
원격 MCP 서버라면 mcp_server 항목에 defer_loading: true를 설정하면 된다. 그러면 해당 서버가 내놓는 툴 전체가 지연 로딩되므로, 큰 서버의 툴을 하나하나 나열할 필요가 없다 [1]. 호출은 mcp_server_tool_call과 mcp_server_tool_result 단계로 돌아온다 [2].
Tool Retrieval 비용은 얼마인가?
Tool Retrieval에는 별도 요금이 없다. 토큰은 모델의 표준 입력, 캐시, 출력 요율로 과금된다 [2]. 절감 효과는 끝내 불러오지 않는 스키마에서 나온다. Google은 토큰이나 지연 시간 수치를 공개하지 않았고, 발표문은 각자 실제 트래픽으로 측정해 보라고 권한다 [1].
비용은 네 부분으로 나눠 계산한다.
tool_search를 켜면 크기가 정해진 소량의 입력 토큰이 더해진다 [1].- 지연 로딩한 툴은 이름과
short_description, 또는description의 첫 문장만total_input_tokens에 더한다 [2]. - 서버 측 검색은 할 때마다 모델 호출이 하나 더 일어나고, 이 호출의 프롬프트 토큰은
total_tool_use_tokens에 잡혀 입력 요율로 과금된다 [2]. - 모델이 불러온 스키마는 처음부터 선언했을 때와 똑같이 남은 대화 내내 입력으로 과금된다 [1].
가이드는 주의할 점 두 가지를 덧붙인다. 지연 로딩 때문에 프롬프트가 최소 캐시 가능 크기보다 작아질 수 있다. 또 툴 라이브러리가 작거나, 컨텍스트가 길면서 매번 검색하는 경우에는 정적 로딩이 더 쌀 수 있다 [2].
Claude의 tool search tool과는 어떻게 다른가?
Gemini Tool Retrieval은 Anthropic이 Claude용으로 내놓은 tool search tool과 같은 패턴을 따르고, defer_loading 플래그를 쓰는 점도 같다. 차이는 검색을 돌리는 방식과, 맞는 툴을 찾지 못했을 때 돌아오는 응답에 있다 [2][4].
| Gemini Tool Retrieval | Claude tool search tool | |
|---|---|---|
| 상태 | 프리뷰, Interactions API, v1beta [2] | Messages API에서 안정 버전 [4] |
| 켜는 법 | {"type": "tool_search"}와 defer_loading | tool_search_tool_regex_20251119 또는 tool_search_tool_bm25_20251119와 defer_loading |
| 자체 검색 로직 | "execution": "client"로 선언한 tool_search | tool_reference 블록을 돌려주는 사용자 정의 툴 |
| MCP | mcp_server 항목의 defer_loading | mcp_toolset 설정의 defer_loading |
| 맞는 툴이 없을 때 | 구조화된 오류가 아닌 텍스트 응답 | 오류가 아닌 빈 tool_references 배열 |
Claude 쪽은 요청 하나에 툴을 최대 10,000개까지 지연 로딩할 수 있고, 검색 한 번에 기본으로 툴 5개를 돌려준다 [4]. Gemini 가이드에는 지연 로딩할 수 있는 툴의 최대 개수나 검색당 결과 수가 나와 있지 않다 [2]. 두 서비스에서 에이전트를 함께 돌린다면 툴 레지스트리 하나를 같이 쓰고, 핵심 툴은 불러 두고 나머지는 미루는 구분도 그대로 가져갈 수 있다. 다만 대화 기록을 다루는 방식이 달라서 코드는 따로 짜야 한다.
AI 에이전트를 운영하는 팀에는 무엇이 달라지나?
팀 입장에서 Tool Retrieval은 Gemini 에이전트 하나가 여러 시스템에 한꺼번에 접근하는 비용을 낮춘다. 지원팀, 운영팀, 재무팀을 함께 돕는 에이전트도 이제 연결된 모든 서비스의 스키마 비용을 매번 전부 치르지 않는다. 응답에 담긴 단계를 보면 모델이 어떤 툴을 찾아봤는지도 알 수 있다. 이 기록은 두 팀이 비슷한 이름의 툴을 각자 관리할 때 쓸모가 있다. 가이드는 비슷한 툴 이름 앞에 서비스 이름을 붙이고, short_description 첫머리에 서비스 이름을 밝히라고 권한다 [2].
클라이언트 측 검색은 사람마다 툴 접근 권한이 다를 때 가장 쓸모가 크다. 검색마다 직접 짠 코드가 답하므로 현재 사용자가 쓸 수 있는 툴만 돌려줄 수 있고, 대화 도중 누군가 새 서비스를 연결하면 해당 툴을 추가할 수도 있다 [1].
한계와 남은 질문은?
Tool Retrieval은 프리뷰라서 정식 출시 전에 API가 바뀔 수 있다. 가이드가 밝힌 한계는 다음과 같다 [2].
- 요청 하나에서 서버 측 검색과 클라이언트 측 검색을 함께 쓸 수 없다.
defer_loading은 서버 측 검색에만 적용된다.- 모델이 응답 한 번에 검색을 여러 번 할 수 있다.
- 불러온 툴은 남은 대화 내내 컨텍스트에 머문다.
- 지연 로딩한 툴과 하나도 맞지 않는 검색은 구조화된 오류가 아니라 텍스트 응답을 돌려준다.
남은 질문은 측정이다. Google은 흔한 규모의 툴 라이브러리에서 토큰이나 지연 시간이 얼마나 되는지 수치를 내놓지 않았고, 재현율(recall) 수치도 없다. 그래서 검색이 정답이었을 툴을 얼마나 자주 놓치는지는 아직 문서만으로 알 수 없다 [1]. 운영 중인 툴 묶음을 지연 로딩하기 전에는 실제 대화 표본으로 지연 로딩을 켰을 때와 껐을 때의 total_input_tokens, total_tool_use_tokens, 툴 호출 정확도를 비교해 보는 편이 좋다.
자주 묻는 질문
Gemini Tool Retrieval을 지원하는 모델은 무엇인가?
Google 가이드에 나온 지원 모델은 gemini-4-carbon, gemini-4-neon, gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash 여섯 가지다. 이 밖의 모델에서 툴을 지연 로딩하는 요청을 보내면 'deferred loading is not supported' 오류가 나며 요청이 실패한다.
Gemini Tool Retrieval은 generateContent에서도 쓸 수 있나?
쓸 수 없다. Tool Retrieval은 프리뷰 기능이라 Interactions API에서만 동작하고, v1beta API 버전이 있어야 한다.
Gemini API에서 Tool Retrieval을 쓰면 요금이 더 나오나?
별도 요금은 없고, 토큰은 모델의 표준 요율로 과금된다. 다만 서버 측 검색은 할 때마다 모델 호출이 하나 더 일어나고, 이 호출의 프롬프트 토큰은 total_tool_use_tokens에 잡혀 입력 요율로 과금된다. 그래서 툴 라이브러리가 작으면 정적 로딩이 더 쌀 수 있다.
Gemini Tool Retrieval에 자체 툴 레지스트리나 임베딩 인덱스를 쓸 수 있나?
쓸 수 있다. tool_search를 선언할 때 execution을 client로 정하고, 애플리케이션에서 검색을 실행한 뒤 완전한 함수 선언을 function_result에 담아 돌려주면 된다. 검색할 때마다 왕복이 한 번 늘고, 대화 도중에도 새 툴을 내놓을 수 있다.
Gemini API에서 MCP 서버의 툴을 모두 지연 로딩하려면 어떻게 하나?
mcp_server 항목에 defer_loading을 true로 설정하고, 서버 측 tool_search 툴을 함께 넣으면 된다. 그러면 해당 서버가 내놓는 툴을 하나하나 나열하지 않아도 모두 필요할 때 불러오고, 호출 결과는 mcp_server_tool_call과 mcp_server_tool_result 단계로 돌아온다.